Stap 1
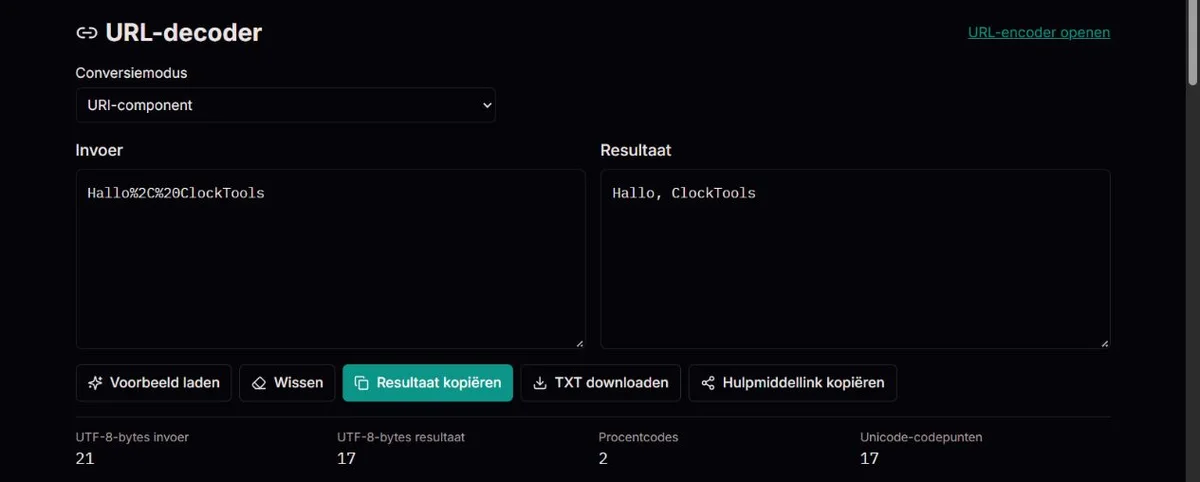
Kies de bijpassende modus
Component decodeert scheidingstekens; volledige URI behoudt hun codes; formulier verandert + in een spatie.
Eén doorgang verwijdert één laag en houdt het origineel bewerkbaar.
Eén doorgang verwijdert één laag en houdt het origineel bewerkbaar.
Component decodeert scheidingstekens; volledige URI behoudt hun codes; formulier verandert + in een spatie.
Onvolledige codes en ongeldige UTF-8 geven een fout zonder de invoer te wijzigen.
Kopieer of download. Onderzoek resterende codes zonder automatisch herhaald decoderen.
Bepaal in een logquery eerst de gecodeerde veldgrenzen. In q=A%26B&lang=en is q gelijk aan A%26B; componentdecodering geeft A&B. Eerst alles decoderen maakt de interne ampersand tot een schijnbare extra scheider.
Bewaar het origineel en deel verzonnen voorbeelden. Gedecodeerde tekst onthult namen of tokens. De pagina onderzoekt een waarde, niet een veldverzameling of bestemming van een omleiding.
Vergelijk C++ met C%2B%2B. Component geeft beide C++; formulier zet letterlijke plussen in spaties om maar %2B in plus.
Ga na welke conventie de afzender gebruikt voordat je een modus kiest. Een onverwachte spatie bewijst geen oorspronkelijke spatie. De +waarschuwing vraagt onderzoek, niet automatisch omschakelen naar formuliermodus.
Decodeer genest %252F één keer tot %2F en bepaal de laag. Een aparte tweede componentstap zou / geven.
Dat kan juist zijn voor een binnenwaarde en fout voor het hele adres. Bewaar elke stap in plaats van door te gaan tot de tekst leesbaar is. Leesbaar bewijst geen handtekening, veilige bestemming of bedoelde padstructuur.
Component decodeert gereserveerde codes in een waarde. Volledige URI bewaart de voor decodeURI structurele codes. Formulier vervangt eerst letterlijke + door spaties en decodeert dan strikt. Kies de afzenderconventie, niet de meest vertrouwde uitvoer.
Verwerkt wordt één string, geen geparseerde verzameling. Bepaal bij meerdere velden eerst gecodeerde scheiders en decodeer daarna namen en waarden. Een interne %26 mag door te vroeg decoderen niet tot veldscheider worden.
JavaScript definieert de bewaarverzameling van decodeURI met slash, ampersand en plus. %2F%26 blijft in volledige URI staan, component geeft /&. Behouden codes kunnen juist resultaat zijn, geen mislukking. ECMAScript decodeURI en bewaarde codes.
%252FGeneste invoer%2FNa één doorgang/Na een aparte tweede doorgang%252F wordt %2F, niet /. Het kan bewust genest zijn of per ongeluk tweemaal gecodeerd. Maak onderscheid voordat je het herstelt.
Decoderen tot niets meer verandert kan gegevens in structuur omzetten. Een schuine streep verandert segmenten en & scheidt velden. Bewaar het origineel en bepaal de verwachte lagen.
decodeURI behoudt %2F en %26; decodeURIComponent haalt ze binnen één waarde terug. De standaard legt uit waarom deze grenzen niet willekeurig verwijderd moeten worden. Decodeerrichtlijnen in RFC 3986.
Twee cijfers na % zijn onvoldoende. %C3%A9 staat voor é, maar %C3%28 is geen geldige UTF-8. Vervangtekens worden niet ingevoegd om de fout te verbergen.
Oudere gegevens kunnen een andere tekencodering gebruiken. Dit hulpmiddel herkent geen tekensets en decodeert geen Latin-1. Zoek de oorspronkelijke codering op.
Bij formulieren wordt + eerst vervangen, zodat %2B een plusteken blijft. Anders dan de tolerante WHATWG-parser weigert deze decoder ongeldige UTF-8-bytes. Verwerkingsvolgorde van WHATWG-formulieren.
De tabel vergelijkt dezelfde formulierachtige invoer. %2B wordt plus in component/formulier; alleen een letterlijke + wordt spatie in formulier. De volgorde bewaart dat verschil. Volledige URI behoudt %2B omdat plus in de bewaarverzameling zit.
De codeteller beschrijft de invoer. Uitvoerbytes en codepunten beschrijven gedecodeerde tekst, geen glyphen. caf%C3%A9 geeft café: twee codes staan voor de twee bytes van é; de uitvoer heeft vijf UTF-8-bytes en vier codepunten. Lege uitvoer met fout is geen geslaagde lege waarde.
Het voorbeeld vervangt invoer, Wissen verwijdert die. Kopiëren en TXT werken op resultaat en zijn zonder uitvoer uitgeschakeld. De hulpmiddellink deelt alleen de pagina; de encoderlink draagt tekst niet over. Bewaar origineel en modus voor een heen-en-terugvergelijking.
| Invoer | Modus | Resultaat |
|---|---|---|
| caf%C3%A9 | URI-component | café |
| A%2BB+C | Formulierwaarde | A+B C |
| A%2BB+C | URI-component | A+B+C |
| %2F%26 | Volledige URI | %2F%26 |
| %252F | URI-component | %2F |
| %C3%28 | URI-component | UTF-8-fout; geen uitvoer |
De foutregel is geen gedeeltelijke tekst. Geen voorbeeld bezoekt of certificeert een adres.
Een eindigend %, %2 of %GG faalt de syntaxcontrole. Een letterlijk procentteken vraagt %25; alles vervangen verbergt echte codes. Controleer bron of afzender in plaats van een correctie voor de onvolledige string te raden.
%E9 heeft geldige syntax maar is alleen geen UTF-8 voor é; %C3%A9 wel. %C3%28 en %FF worden ondanks twee cijfers per code geweigerd. De strikte fout maakt een byteprobleem zichtbaar. Dit is geen Latin-1-decoder of charsetdetector.
Als %2F blijft staan, onderscheid behoud in volledige URI van een gecodeerd buitenprocentteken. Controleer modus en origineel vóór opnieuw decoderen. Een losse % in gemengde tekst kan alles laten falen; invoer blijft bewerkbaar, zonder gedeeltelijk resultaat.
Gebruik bij kopieer- of exportfout het zichtbare resultaat en de andere actie. Deel geen privéomleidingen of credentials in meldingen. Decoderen controleert geen host, handtekening, bereikbaarheid of vertrouwen; de pagina opent het adres niet.
Codes worden gecontroleerd vóór één strikte JavaScript-doorgang. Formulier normaliseert eerst plustekens. Een fout geeft geen gedeeltelijk resultaat en vervangt de invoer niet.
Het resultaat bewijst geen veiligheid of bereikbaarheid. Links worden niet geopend; handtekeningen, volledige formulieren en andere tekencoderingen worden niet gecontroleerd.
Herstel de oorspronkelijke code of vraag geldige UTF-8. Meld modus en verzonnen voorbeeld, geen privéverwijzingen. Test de correctie bij de ontvanger.
Deze modus behoudt gereserveerde tekens; kies component voor een waarde.
Alleen formulier ziet een letterlijk plusteken als spatie.
Nee. Elke doorgang verwijdert één laag.
E9 alleen is geen geldig UTF-8 voor é; daarvoor zijn C3 A9 nodig. Een andere decoder kan een oud charset aannemen of bytes vervangen. Zoek de broncodering in plaats van een leesbare letter als bewijs te nemen. Deze pagina gebruikt bewust strikt UTF-8.
Syntax en UTF-8 zijn aparte controles. C3 begint een multibytereeks; 28 is geen geldig vervolgbyte. Er volgt een fout zonder gedeeltelijke uitvoer, met bewerkbaar origineel om het ontbrekende of veranderde byte te onderzoeken.
Nee. %26 kan & en een valse scheider worden. Bepaal eerst gecodeerde grenzen en decodeer elke waarde volgens conventie. Deze pagina doet geen gestructureerde parsing en bouwt geen gecorrigeerde query.
Controleer status. Lege invoer geeft leeg; foutieve syntax of UTF-8 ook, maar met foutmelding. Het origineel blijft corrigeerbaar en kopiëren/export zijn uitgeschakeld. Een fout betekent niet dat ongewenste tekens zijn opgeschoond.
Dit is een procentdecoder, geen algemene formatselector. & en Base64 worden niet volgens hun formats gelezen. Bepaal de echte codering en gebruik het passende hulpmiddel; ongewijzigde tekst bewijst geen procentcodering.