Stap 1
Beide versies plakken
limit = 8
     →
limit = 12
Zet het origineel links en de revisie rechts, inclusief de volledige laatste regel.
Vergelijk regels, woorden of tekens, normaliseer Unicode en regeleinden expliciet en exporteer een exacte patch.
Vergelijk regels, woorden of tekens, normaliseer Unicode en regeleinden expliciet en exporteer een exacte patch.
limit = 8
→
limit = 12Zet het origineel links en de revisie rechts, inclusief de volledige laatste regel.
8  ≠  12

CRLF  ≠  LF
Regels voor structuur, woorden voor formulering en tekens voor leestekens. Gebruik alleen passende negeerregels.
- limit = 8
+ limit = 12
  retry = true
Bekijk verwijderingen en toevoegingen naast elkaar of gecombineerd. De patch beschrijft de exacte invoer.
Vergelijk een aankondiging en revisie in Woorden zonder negeerregels. Lees een gewijzigde datum of kan dat zal wordt in context; bekijk leestekens daarna in Tekens. Gesplitste weergave helpt elke versie te lezen. Een hoge score kan de enige belangrijke wijziging bevatten en keurt niets goed.
Gebruik Regels voor een klein blok en behoud witruimte wanneer inspringing belangrijk is. Verandert elke regel na systeemwissel, probeer regeleindenormalisatie apart. Bewaar de ruwe patch en valideer de revisie met haar parser of tests. YAML, JSON, SQL en uitvoerbare code worden niet geïnterpreteerd.
Vergelijk gelijk uitziende labels exact in Tekens en schakel daarna alleen NFC in. Verdwijnt een accentverschil, dan speelde canonieke representatie mee. Test regeleindes afzonderlijk. Geen optie verwijdert alle onzichtbare of gelijkende tekens; verklein het voorbeeld vóór je een weergavefout concludeert.
- limit = 8
+ limit = 12
  retry = true
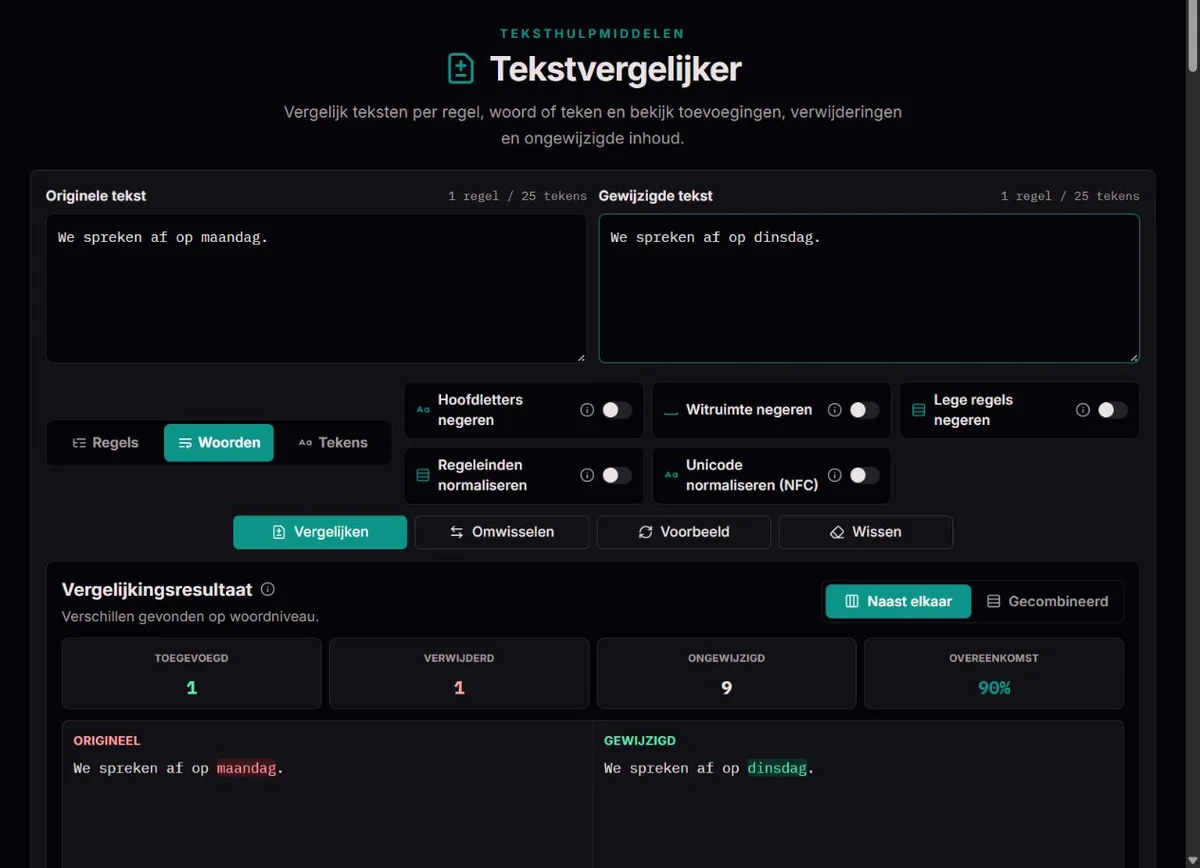
Een diff registreert een bewerking in plaats van twee documenten te herhalen. GNU’s documentatie over unified-formaat beschrijft het compacte formaat met gewijzigde regels en nabijgelegen context.
Context helpt de bewerking te plaatsen. De download noemt original.txt en revised.txt en beschrijft regels, ook als de weergave woorden vergelijkt.
Herhaalde regels laten meerdere uitlijningen toe. De engine vindt een bewerkingsreeks, niet de bedoeling van de auteur. Controleer de omgeving van verplaatste zinnen.
Een letter met accent kan één codepunt zijn of een letter met een combinerend teken. De Unicode-specificatie voor normalisatie definieert canonieke gelijkwaardigheid. NFC verandert alleen de vergelijking, niet de invoervelden.
CRLF en LF verschillen. De optie behandelt CRLF en losse CR als LF. Lege regels negeren verwijdert ook hun scheidingsinformatie.
Gelijkenis is tweemaal de ongewijzigde tokens gedeeld door het totaal van beide versies. Eenheid en negeerregels veranderen het percentage. Het meet geen betekenis, plagiaat of juistheid.
De modus Regels behandelt een complete regel inclusief einde als token. Handig voor lijsten, logs, schema's, ondertitels en configuratie, maar één veranderd woord kan de hele regel markeren. De modus Woorden volgt de tokenisering van de vergelijkingslogica voor tekst, leestekens en betekenisvolle witruimte. Afhankelijk van het schriftsysteem en de leestekens kan één woord in fragmenten worden gesplitst; de aantallen betreffen vergelijkingstokens, geen taalkundige woorden. De modus Tekens helpt bij decimalen, URL's, identifiers en kleine schrijfwijzigingen.
Bekijk eerst structuur, dan de onzekere bewerking. Een verplaatste alinea kan verdwijnen en elders verschijnen zonder semantische verplaatsingsherkenning. Herhaalde regels laten meerdere uitlijningen toe: lees context. De tool vergelijkt twee geplakte strings, zonder repositorygeschiedenis, driewegmerge, opmerkingen of auteursbedoeling.
Alle regels starten uit. Bekijk eerst het exacte resultaat, schakel daarna één optie in. Hoofdletters negeren gebruikt kleine letters, geen taalgebonden vergelijking. Lege regels negeren verwijdert witruimteregels en voegt de rest met LF samen; ook regeleindes en eindgrenzen kunnen verdwijnen. Het is geen louter visueel inklappen.
Witruimte negeren verschilt per eenheid. De modus Regels verwijdert witruimte aan het begin en einde van regels en groepeert spaties of tabs, waardoor inspringing en eindverschillen kunnen verdwijnen. De modus Woorden maakt van elke reeks één spatie. De modus Tekens verwijdert de witruimte: a b kan gelijk zijn aan ab. Activeer dit niet voor een mooier percentage; bepaal of weggelaten scheidingstekens echt onbelangrijk zijn.
| Voorbeeld | Optie | Gevolg |
|---|---|---|
| LF / CRLF | Regeleindes normaliseren | CRLF en losse CR worden LF bij vergelijking; editors blijven gelijk. |
é / e + U+0301 | NFC | Canonieke gelijkwaardigheid zonder accenten te verwijderen. |
Label / label | Hoofdletters negeren | Verbergt soms belangrijke verschillen in code of namen. |
a b / ab | Tekens + witruimte negeren | Verbergt scheiding; de ruwe teksten verschillen. |
Origineel links, revisie rechts: min/rood betekent verwijderd, plus/groen toegevoegd. Neutraal past onder de regels, niet noodzakelijk bytegelijk. Gesplitst bewaart beide kanten, samengevoegd toont de reeks. Omwisselen keert richting om en maakt toevoegingen verwijderingen, zonder waardeoordeel over versies.
Reproduceerbaar voorbeeld in Regels zonder negeren: limit = 8 wordt limit = 12, beide met regeleinde gevolgd door retry = true en een slotregeleinde. Eén regel verwijderd, één toegevoegd, één gelijk. Overeenkomst is 50 %: 2 × 1 / (2 + 2). Woorden en Tekens tellen andere tokens en geven andere scores voor dezelfde wijziging.
Diff kopiëren en downloaden leveren een samengevoegde regelpatch van de originele invoer met original.txt en revised.txt. NFC, normalisatie en negeerregels herschrijven hem niet. Een genormaliseerd scherm kan gelijkheid tonen terwijl de patch een representatiewijziging bewaart. Noteer de instellingen voor een andere beoordelaar.
De bestandskop benoemt vóór/na; blokkoppen geven regelbereiken aan. Voorloopspatie is context, min oude regel en plus nieuwe. Ontbrekend slotregeleinde kan ook worden vastgelegd. Een patch beschrijft een transformatie, geen opgeslagen commit. Controleer doel en uitgangsversie in het toepasprogramma; deze pagina past niets toe en lost geen conflicten op.
Een fout betekent berekening niet afgerond, niet gelijkheid. Elke invoer kent een limiet van 50.000 UTF-16-eenheden; ingewikkelde edits kunnen eerder het werkbudget bereiken. De patch heeft een eigen begrensde berekening en kan ook ontbreken. Verdeel grote teksten in betekenisvolle stukken met context. Een percentage in foutstatus is geen geldig resultaat.
Controleer volledige invoer, zet regels uit en vergelijk een fragment in Tekens. NFC stelt rechte en gekrulde aanhalingstekens, gewone en vaste spaties of gelijkende Latijnse en Cyrillische letters niet gelijk. Tokens zijn codepunten, geen complete emoji of grafemen. Voor opmaak, opmerkingen, tabellen en binaire encoderingen ga je terug naar de originele bestanden of een bestandsvergelijker.
De lokale berekening beperkt elk veld tot 50.000 JavaScript-stringeenheden en begrenst het bewerkingswerk. Regels kunnen spaties samenvoegen, woorden witruimte normaliseren en tekens die verwijderen.
De weergave kan genegeerde verschillen verbergen, maar de patch behoudt ruwe invoer. Tekens zijn codepunten, niet altijd complete zichtbare grafemen. Grote wijzigingen kunnen het werkbudget bereiken. Syntax en veiligheid worden niet gecontroleerd.
Schakel negeerregels uit, controleer de invoer en vergelijk een kleiner deel. Meld een kort verzonnen voorbeeld met de eenheid en normalisatieopties.
Nee. De patch beschrijft exacte invoer, inclusief verborgen verschillen.
Nee. De inhoud verschijnt als tekst en wordt letterlijk vergeleken.
Lengte- en werklimieten bewaken de reactiesnelheid. Splits documenten in relevante delen.
NFC behandelt canonieke gelijkwaardigheid, niet alle visuele gelijkenis. Verwisselbare letters, nulbreedtetekens, vaste spaties en aanhalingstekens kunnen verschillen. Vergelijk een kort fragment exact en inspecteer zo nodig codepunten. Verwijder onzichtbare tekens niet blind uit code of identifiers.
Ja: ontkenning, datum, decimaal of toestemming kan meer betekenen dan duizenden gelijke tokens. De score beschrijft uitlijning en regels, geen semantische kwaliteit, plagiaat of goedkeuring. Lees elke wijziging die het doel raakt.
Het resultaat beschrijft toevoegen en verwijderen, geen semantisch verplaatsen. De alinea kan hier verdwijnen en daar bijkomen. Herhaling beïnvloedt uitlijning. Bekijk buren in gesplitste weergave en de eindvolgorde; kleur betekent niet altijd nieuw geschreven tekst.
Invoer blijft in paginageheugen, zonder herstel na herladen. Delen opent de tool zonder teksten. Bewaar originelen of export vóór vertrek. De patch onthult veranderingen en verdient dezelfde zorg als de vergeleken inhoud.
Zonder regels wordt de andere tekst volledig toegevoegd of verwijderd. Twee lege invoeren geven 100 % volgens afspraak, niet een geslaagde documentcontrole. Een regel kan alle witruimte verwijderen. Controleer invoer en berekeningsstatus vóór interpretatie.