Passaggio 1
Scegli la modalità corretta
Componente decodifica separatori; URI completo conserva gli escape; modulo trasforma + in spazio.
Un passaggio rimuove uno strato e conserva l’originale modificabile.
Un passaggio rimuove uno strato e conserva l’originale modificabile.
Componente decodifica separatori; URI completo conserva gli escape; modulo trasforma + in spazio.
Escape incompleti e UTF-8 non valido producono un errore senza cambiare l’input.
Copia o scarica. Esamina gli escape rimasti senza decodificarli più volte automaticamente.
In un log individua prima i campi codificati. In q=A%26B&lang=en, q vale A%26B; componente produce A&B. Decodificare tutto prima rende l’ampersand interno simile a un separatore.
Conserva l’originale e condividi campioni inventati. Il testo rivela nomi o token. La pagina ispeziona un valore, non una raccolta di campi né una destinazione di redirect.
Confronta C++ e C%2B%2B. Componente dà C++ per entrambi; la modalità modulo trasforma i segni + presenti nell’input in spazi, ma decodifica %2B come segno +.
Determina la convenzione del mittente prima di cambiare. Spazio inatteso non prova spazio originale. L’avviso + invita a indagare, non a selezionare automaticamente modulo.
Per un valore annidato, decodifica %252F una volta in %2F e determina lo strato. Un secondo passaggio componente separato produce /.
Può essere giusto per un valore interno e sbagliato per l’indirizzo completo. Conserva ogni fase anziché continuare fino alla leggibilità. Leggere non verifica firma, destinazione o percorso previsto.
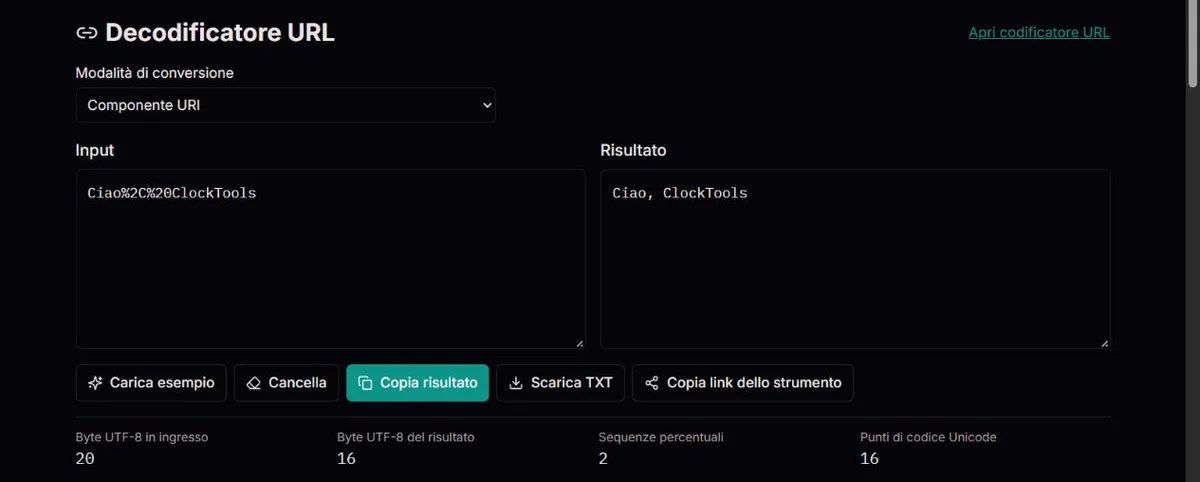
Componente decodifica escape riservati nel valore. URI completa conserva quelli strutturali per decodeURI. Modulo cambia prima + letterali in spazi e poi decodifica rigorosamente. Scegli la convenzione del mittente, non il risultato familiare.
Si elabora una stringa, non una raccolta analizzata. Per più campi individua separatori codificati prima di decodificare nomi e valori. Un %26 interno non deve diventare separatore per un passaggio prematuro sull’intera raccolta.
JavaScript definisce l’insieme conservato da decodeURI, compresi barra, ampersand e più. %2F%26 resta in URI completa, componente dà /&. Sequenze mantenute possono essere corrette, non un fallimento. ECMAScript decodeURI e insieme di sequenze conservate.
%252FInput annidato%2FDopo un passaggio/Dopo un secondo passaggio separato%252F diventa %2F, non /. Può trattarsi di un valore annidato apposta o codificato due volte per errore. Occorre distinguere le cause.
Decodificare finché nulla cambia può trasformare dati in struttura. Una barra modifica i segmenti e & separa i campi. Conserva l’originale e verifica gli strati attesi.
decodeURI mantiene %2F e %26; decodeURIComponent li recupera dentro un valore. La norma spiega perché questi confini non vanno cancellati indiscriminatamente. Indicazioni di decodifica del RFC 3986.
Due cifre dopo % non bastano. %C3%A9 rappresenta é; %C3%28 non è UTF-8 valido. Non si inseriscono simboli sostitutivi che nascondano il problema.
Dati vecchi possono usare un altro insieme di caratteri. Lo strumento non rileva codifiche e non interpreta Latin-1. Recupera la codifica originale.
Nel modulo + viene sostituito prima di decodificare, quindi %2B resta un più. A differenza dell’analizzatore tollerante WHATWG, qui i byte UTF-8 non validi vengono rifiutati. Ordine di analisi dei moduli WHATWG.
La tabella confronta lo stesso ingresso simile a modulo. %2B diventa più in componente/modulo; solo + letterale diventa spazio in modulo. L’ordine mantiene la differenza. URI completa conserva %2B perché più è nell’insieme conservato.
Il contatore escape descrive l’ingresso. Byte e punti d’uscita descrivono testo, non glifi. caf%C3%A9 dà café: due sequenze rappresentano i due byte di é; uscita ha cinque byte UTF-8 e quattro punti di codice. Uscita vuota con errore non è valore vuoto riuscito.
L’esempio sostituisce ingresso, Cancella lo elimina. Copia e TXT agiscono sul risultato e sono disattivati senza uscita. Il link condivide solo pagina, quello dell’encoder non trasferisce testo. Conserva originale e modo per confrontare andata e ritorno.
| Ingresso | Modalità | Risultato |
|---|---|---|
| caf%C3%A9 | Componente URI | café |
| A%2BB+C | Valore di modulo | A+B C |
| A%2BB+C | Componente URI | A+B+C |
| %2F%26 | URI completa | %2F%26 |
| %252F | Componente URI | %2F |
| %C3%28 | Componente URI | Errore UTF-8; nessuna uscita |
La riga di errore non è testo parziale. Nessun esempio visita o certifica un indirizzo.
Un %, %2 o %GG finale fallisce la sintassi. Un segno % letterale richiede %25; sostituirli tutti nasconderebbe sequenze valide. Controlla fonte o mittente, non indovinare una correzione dalla stringa incompleta.
%E9 è sintatticamente giusto ma solo non rappresenta é in UTF-8; %C3%A9 sì. %C3%28 e %FF sono respinti anche con due cifre per escape. L’errore rigoroso rivela problema di byte. Non è decoder Latin-1 né rilevatore charset.
Se resta %2F, distingui conservazione di URI completa e percento codificato esterno. Controlla modo e originale prima di un’altra passata. Un % isolato in testo misto può fallire tutto: ingresso resta modificabile senza risultato parziale.
Se fallisce copia o export, usa risultato visibile e altra azione disponibile. Non inviare redirect privati o credenziali. Decodificare non verifica host, firma, accessibilità o fiducia; la pagina non apre l’indirizzo.
Gli escape vengono controllati prima di un passaggio rigoroso JavaScript. Modulo normalizza prima i più. Gli errori non producono risultati parziali né sostituiscono l’input.
Il risultato non prova sicurezza o raggiungibilità. Nessun link viene aperto; firme, moduli completi e codifiche diverse da UTF-8 non vengono verificati.
Correggi la sequenza originale o richiedi UTF-8 valido. Segnala modalità ed esempio fittizio, non reindirizzamenti privati. Prova la correzione con il destinatario.
La modalità conserva i delimitatori riservati; usa componente per un valore.
Solo la modalità modulo interpreta un segno + presente nell’input come spazio.
No. Ogni passaggio rimuove uno strato.
E9 solo non è UTF-8 valido per é; servono C3 A9. Un altro può assumere vecchio charset o sostituire byte. Trova la codifica originale invece di considerare una lettera leggibile prova. Qui c’è soltanto UTF-8 rigoroso.
Sintassi e UTF-8 sono controlli diversi. C3 inizia una sequenza multibyte, 28 non è continuazione valida. L’errore non fornisce uscita parziale e mantiene l’originale modificabile per cercare il byte mancante o cambiato.
No. %26 diventa & e può essere falso separatore. Trova prima confini codificati e decodifica valori per convenzione. Il tool non fa analisi strutturata né monta query corretta.
Controlla lo stato. Ingresso vuoto dà vuoto; errori di sintassi o UTF-8 anche, ma con messaggio. Originale resta correggibile e copia/export disattivati. Errore non significa pulizia di caratteri indesiderati.
È un decoder percentuale, non un selettore generale. & e Base64 non sono interpretati nei loro formati. Ottieni la codifica reale e usa il tool corrispondente: immutato non prova codifica percentuale.