Passaggio 1
Incollare entrambe le versioni
limit = 8
     →
limit = 12
Metti l’originale a sinistra e la revisione a destra, compresa l’ultima riga completa.
Confronta righe, parole o caratteri, normalizza esplicitamente Unicode e terminatori di riga ed esporta una patch esatta.
Confronta righe, parole o caratteri, normalizza esplicitamente Unicode e terminatori di riga ed esporta una patch esatta.
limit = 8
→
limit = 12Metti l’originale a sinistra e la revisione a destra, compresa l’ultima riga completa.
8  ≠  12

CRLF  ≠  LF
Righe per la struttura, parole per la scrittura e caratteri per la punteggiatura. Attiva solo le esclusioni pertinenti.
- limit = 8
+ limit = 12
  retry = true
Controlla rimozioni e aggiunte affiancate o insieme. La patch descrive gli input esatti.
Confronta comunicato e revisione in Parole, senza regole di esclusione. Leggi una data cambiata o il passaggio da può a farà nel contesto, poi controlla la punteggiatura in Caratteri. La vista separata aiuta a rileggere ogni versione. Un valore alto può contenere l'unica modifica decisiva; non approva il testo.
Scegli Righe per un piccolo blocco e mantieni gli spazi quando il rientro conta. Se cambiare sistema segna ogni riga, prova separatamente a normalizzare i terminatori di riga. Esporta la patch grezza per la revisione e valida il nuovo file con parser o test. YAML, JSON, SQL e codice non vengono interpretati qui.
Confronta etichette visivamente uguali in Caratteri senza normalizzazione, poi attiva solo NFC. Se la differenza d'accento scompare, era coinvolta la rappresentazione canonica. Prova le terminazioni separatamente. Nessuna opzione elimina tutti gli invisibili o somiglianti; riduci l'esempio prima di attribuirlo alla schermata.
- limit = 8
+ limit = 12
  retry = true
Un diff registra una modifica anziché ripetere due documenti. La documentazione GNU sul formato unificato descrive il formato compatto con righe modificate e contesto vicino.
Il contesto aiuta a localizzare la modifica. Il download usa original.txt e revised.txt e descrive righe anche quando la vista confronta parole.
Le righe ripetute consentono più allineamenti. Il motore trova una sequenza di modifiche, non l’intenzione dell’autore. Verifica il contesto delle frasi spostate.
Una lettera accentata può essere un punto di codice o una lettera seguita da un segno combinante. La specifica di normalizzazione Unicode definisce equivalenza canonica. NFC cambia solo il confronto, non i campi.
CRLF e LF sono sequenze diverse. La normalizzazione tratta CRLF e CR isolati come LF. Ignorare righe vuote elimina anche le informazioni di separazione.
La somiglianza è due volte le unità invariate divise per il totale delle due versioni. Dipende da unità ed esclusioni; non misura significato, plagio o correttezza.
La modalità Righe considera una riga completa con terminazione come unità. È utile per elenchi, log, scalette, sottotitoli e configurazioni, ma una parola può segnare tutta la riga. La modalità Parole segue la suddivisione del motore di confronto per testo, punteggiatura e spazi significativi. A seconda del sistema di scrittura e della punteggiatura, una parola può essere divisa in frammenti; i totali contano unità di confronto, non parole in senso linguistico. La modalità Caratteri aiuta con decimali, URL, identificatori e piccoli refusi.
Controlla la struttura prima di restringere la modifica incerta. Un paragrafo spostato può apparire rimosso e aggiunto, senza riconoscimento semantico di movimento. Righe ripetute permettono allineamenti differenti: serve contesto. Si confrontano due stringhe incollate, senza storia del repository, merge a tre vie, commenti o comprensione dell'intento.
Tutte le regole iniziano disattivate. Guarda prima il confronto esatto e attivane una per volta. Ignora maiuscole converte in minuscolo, senza confronto linguistico. Ignora righe vuote elimina quelle di soli spazi e riunisce con LF; può nascondere terminazioni e confini finali. Non è soltanto comprimere la vista.
Ignora spazi cambia secondo unità. In Righe elimina margini e raggruppa spazi o tabulazioni, nascondendo rientri e anche alcune terminazioni. In Parole riduce sequenze a uno spazio. In Caratteri le elimina: a b può corrispondere a ab. Non attivarlo per alzare il punteggio; decidi se i separatori omessi influenzano il lavoro.
| Esempio | Opzione | Effetto |
|---|---|---|
| LF / CRLF | Normalizza terminazioni | CRLF e CR singolo diventano LF per confrontare; editor invariati. |
é / e + U+0301 | NFC | Equivalenza canonica, senza togliere accenti. |
Label / label | Ignora maiuscole | Nasconde distinzioni talvolta importanti per codice o nomi. |
a b / ab | Caratteri + ignora spazi | Nasconde il separatore; gli originali differiscono. |
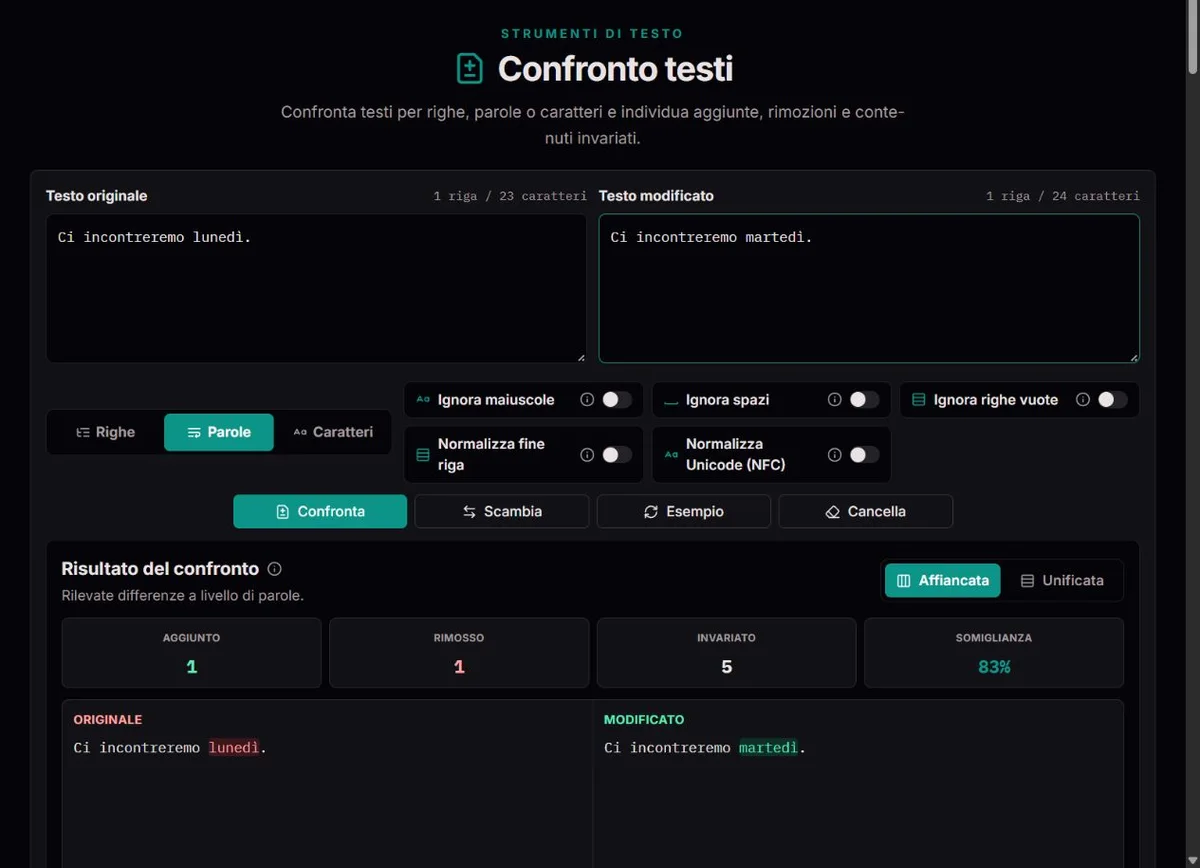
Originale a sinistra, revisione a destra: meno/rosso è rimozione, più/verde aggiunta. Neutro coincide secondo le regole, non necessariamente byte per byte. Separata mantiene i lati, unificata intreccia le modifiche. Scambia inverte direzione e aggiunte/rimozioni, senza giudicare quale versione sia migliore.
Esempio riproducibile in Righe senza esclusioni: limit = 8 diventa limit = 12, entrambi seguiti da interruzione e retry = true con interruzione finale. Una riga rimossa, una aggiunta e una uguale. Somiglianza 50 %: 2 × 1 / (2 + 2). Parole e Caratteri usano altre unità e danno valori diversi per la stessa modifica.
Copia e scarica diff producono una patch unificata per righe delle stringhe originali, chiamate original.txt e revised.txt. NFC, normalizzazioni ed esclusioni non riscrivono l'export. La schermata normalizzata può sembrare identica e la patch conservare una differenza di rappresentazione. Annota le opzioni per chi rivedrà il file.
L'intestazione identifica prima/dopo; ogni blocco indica intervalli di righe. Spazio iniziale significa contesto, meno vecchia riga, più nuova. Può essere segnalata anche l'assenza di interruzione finale. La patch è una trasformazione, non un commit salvato. Verifica destinazione e base nello strumento che la applica: questa pagina non applica patch né risolve conflitti.
Un errore significa calcolo incompleto, non uguaglianza. Ogni input ammette 50.000 unità UTF-16, ma modifiche complesse possono esaurire il budget prima. La patch ha un calcolo limitato indipendente e può mancare. Dividi testi grandi in sezioni con contesto. Non interpretare una percentuale nello stato di errore come risultato valido.
Verifica entrambi gli incolli completi, disattiva regole e confronta un frammento in Caratteri. NFC non equipara virgolette dritte e curve, spazi comuni e non separabili, lettere latine e cirilliche simili. Le unità sono punti di codice, non interi emoji o grafemi. Per formattazione, commenti, tabelle o codifiche binarie torna al documento o usa confronto di file.
Il calcolo locale limita ogni campo a 50.000 unità di stringa JavaScript e limita il lavoro di modifica. Le righe possono ridurre spazi, le parole normalizzarli e i caratteri rimuoverli.
La vista può nascondere differenze ignorate, ma la patch conserva gli input originali. I caratteri sono punti di codice, non sempre grafemi completi. Modifiche grandi possono superare il budget. Non si verifica sintassi o sicurezza.
Disattiva esclusioni, verifica gli input e confronta una sezione più piccola. Segnala problemi con un esempio inventato breve, modalità e opzioni di normalizzazione.
No. Descrive gli input esatti, comprese le differenze nascoste nella vista.
No. È visualizzato come testo e confrontato letteralmente.
I limiti di lunghezza e lavoro proteggono la reattività. Dividi i documenti in sezioni rilevanti.
NFC riguarda equivalenza canonica, non ogni somiglianza visiva. Lettere confondibili, caratteri senza larghezza, spazi non separabili e virgolette possono restare distinti. Confronta un frammento esattamente e controlla i punti di codice se necessario. Non cancellare invisibili alla cieca nel codice o nelle identificazioni.
Sì: negazione, data, decimale o permesso può contare più di migliaia di unità uguali. La percentuale descrive allineamento e regole, non qualità semantica, plagio o approvazione. Leggi ogni modifica rilevante per lo scopo.
Si rappresentano aggiunte e rimozioni, non spostamenti semantici. Il paragrafo può sparire qui e riapparire altrove. Ripetizioni influenzano l'allineamento. Guarda vicini e ordine finale nella vista separata: colore non significa sempre testo appena scritto.
Gli input restano nella memoria della pagina, senza ripristino dopo ricaricamento. Condividere apre lo strumento senza i testi. Conserva originali o export prima di uscire. La patch rivela modifiche e richiede la stessa attenzione del materiale esaminato.
Senza esclusioni, l'altro lato è interamente aggiunto o rimosso. Due input vuoti danno 100 % per convenzione, non dimostrano una revisione. Una regola può eliminare il solo contenuto di spazi. Controlla input e stato del calcolo prima di leggere un risultato vuoto.