Passaggio 1
Incolla gruppi separati
... --- ... / .x-SOS [?]Usa spazi tra caratteri e / o ritorni a capo tra parole. Sono accettate varianti tipografiche.
Decodifica punti e linee separati, conserva i gruppi sconosciuti e scegli l’interpretazione dei segnali di procedura.
Decodifica punti e linee separati, conserva i gruppi sconosciuti e scegli l’interpretazione dei segnali di procedura.
... --- ... / .x-SOS [?]Usa spazi tra caratteri e / o ritorni a capo tra parole. Sono accettate varianti tipografiche.
La normalizzazione mantiene i caratteri sconosciuti. Confronta ogni [?] con l’originale.
.x-[?]Attiva i segnali di procedura quando appropriato e verifica la trascrizione prima di copiarla.
Conserva una copia dell'indizio esattamente come ricevuto. Incolla una riga breve, controlla i separatori di parola e usa Normalizza spaziatura per standardizzare i segni tipografici accettati. Se ... --- ... / .x- produce SOS [?], isola .x- e confrontalo con la fonte o con la tabella. Non eliminare x solo perché .- produrrebbe una A plausibile. Quando il mittente conferma il gruppo previsto, ripara quel solo gruppo e decodifica di nuovo l'intero indizio. Questo lascia una traccia chiara tra ciò che il rompicapo forniva, ciò che il convertitore ha riconosciuto e ciò che hai cambiato.
Copia i punti e le linee effettivi dalla grafica, non una nuova conversione della frase prevista. Per un nome o una data, confronta il risultato carattere per carattere con la fonte approvata. Controlla se un'interruzione di riga del layout si è trasformata in confine di parola e se una linea lunga decorativa è accettata come linea. Se ogni gruppo è valido ma le parole sono sbagliate, esamina gli spazi persi: la validità non rileva un messaggio riordinato. Correggi la grafica e ripeti il controllo sulla versione finale prima di ordinare le stampe.
Per una breve frase di addestramento generata, ascolta una volta con impostazioni fisse, scrivi i caratteri che pensi di aver sentito e trascrivi separatamente i gruppi di segni quando serve. Usa il decodificatore per ispezionare un gruppo contestato, poi confronta il tuo testo con la frase originale. Per un secondo passaggio, mantieni la velocità dei caratteri a 18 WPM e abbassa la velocità Farnsworth a 10 WPM se il problema è seguire tra le lettere. Questa pagina aiuta a controllare una trascrizione; non valuta il tuo udito, non cattura input da microfono e non riconosce una registrazione caricata.
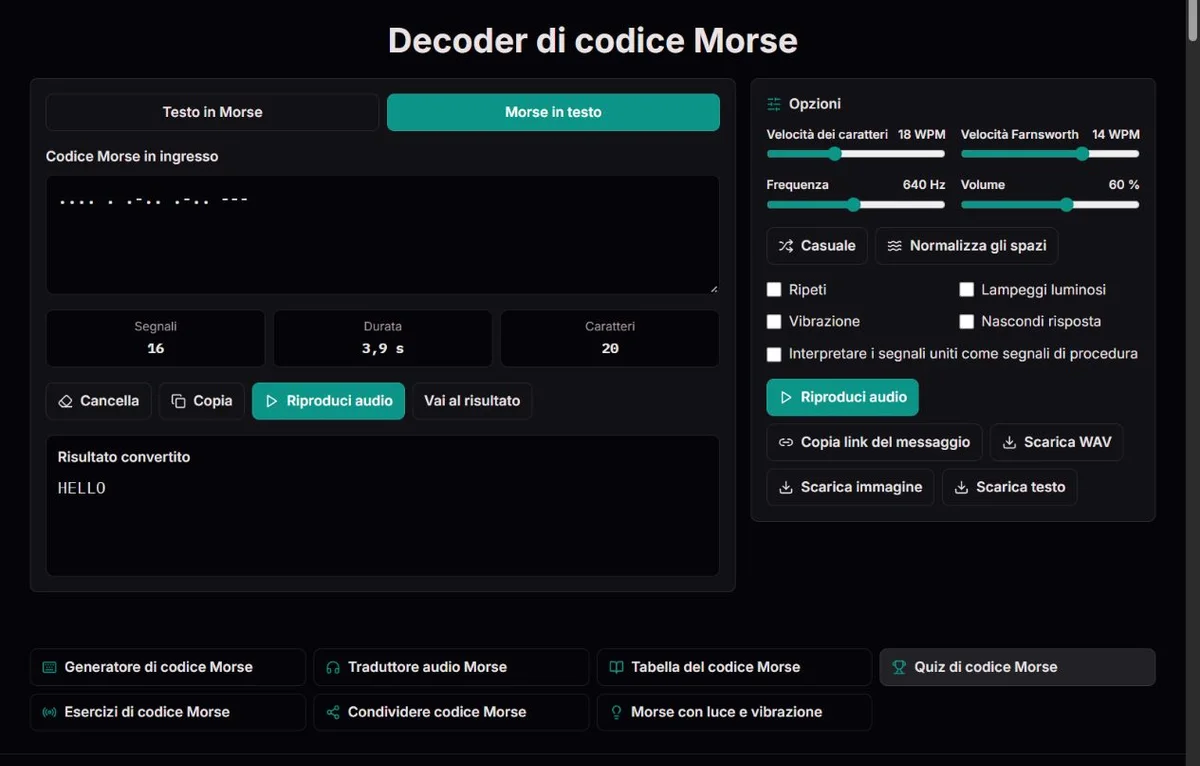
Inserisci punti e linee con spazi tra i gruppi di caratteri. Una barra divide le parole, e un'interruzione di riga è trattata come un altro separatore di parola. I separatori di parola iniziali o ripetuti vengono ripuliti invece di creare parole vuote. Il testo convertito si aggiorna dai gruppi normalizzati, ma dipende comunque dai confini che hai fornito. Gli spazi ordinari non sono un segnale di confine di parola in questa notazione.
Confronta ..., . . . e . / . / .. Il primo è S, il secondo EEE e il terzo E E E. Un flusso ininterrotto non è decodificabile in modo univoco perché gli schemi dei caratteri Morse hanno lunghezze diverse. Anche .- può essere A oppure E seguito da T se si ammette una pausa mancante. Un decodificatore che scegliesse una parola plausibile starebbe indovinando, non recuperando informazioni preservate nell'input.
Quando un mittente ha fornito lettere separate ma nessun separatore di parola, le lettere possono comunque essere decodificate, anche se le divisioni tra parole sono perse. Chiedi il raggruppamento originale prima di aggiungerle. Se un indizio lungo è solo mandato a capo visivamente, rimuovi deliberatamente gli a capo editoriali mantenendo i veri separatori di parola. Non fondere tutto in un unico flusso; i confini tra lettere sono più importanti della compattezza dell'input.
| Input Morse | Risultato | Interpretazione |
|---|---|---|
... | S | Un carattere |
. . . | EEE | Tre caratteri in una parola |
. / . / . | E E E | Tre parole di un carattere |
..--.. | ? | Un punto interrogativo riconosciuto |
| .x- | [?] | Un gruppo non riconosciuto da rivedere |
Il decodificatore accetta punti fermi come punti e trattini come linee. Punti mediani e pallini diventano punti; trattini medi, trattini lunghi e segni meno matematici diventano trattini. Una barra verticale o una barra inversa è normalizzata a separatore di parola. Spaziature e separatori ripetuti vengono resi coerenti. Questi cambiamenti sono utili quando si copia codice da un documento con sostituzioni tipografiche.
Normalizza spaziatura conserva i caratteri non familiari all'interno di un gruppo. Quindi .x- resta non valido invece di diventare silenziosamente .-. Questa distinzione conta: eliminare x creerebbe A e nasconderebbe il problema originale. Lo stesso vale per virgole usate come puntini, simboli decorativi o un errore OCR. La normalizzazione accettata non è un servizio di riconoscimento ottico dei caratteri, e lo strumento non interpreta ogni segno grafico che assomiglia a un punto o a una linea.
Salva l'originale prima di normalizzare una trascrizione di materiale d'archivio. Una copia di lavoro normalizzata può essere più facile da decodificare, ma non conserva più la tipografia esatta, il layout delle righe o i separatori della fonte. Se il contesto conta, annota quali cambiamenti erano meccanici e quali implicavano una decisione editoriale. Per un indizio in classe, è un'occasione per distinguere il cambiamento di una rappresentazione dal cambiamento della sua informazione.
... --- ... / .x- produce SOS [?]. I gruppi riconosciuti sono conservati, e il gruppo non valido è visibile nel risultato e nell'avviso. [?] è un segnaposto, non il risultato di un punto interrogativo codificato. Un vero punto interrogativo è ..--.. e si decodifica come ?. Mantieni questa distinzione quando correggi un indizio che contiene sia incertezza sia punteggiatura.
I gruppi sconosciuti sono elencati distintamente nell'avviso, quindi l'elenco non è necessariamente il conteggio di ogni occorrenza. Usa il risultato per localizzare i segnaposto ripetuti e ispeziona i gruppi di input corrispondenti. Un singolo gruppo non valido impedisce una sequenza temporale di riproduzione valida per l'intero input Morse. Rimuovere il gruppo renderebbe riproducibile la sequenza restante, ma rimuoverebbe anche informazione; fallo solo se intendi esplicitamente un estratto incompleto.
Un risultato valido può comunque essere sbagliato. Se ... doveva essere ...., il convertitore restituisce S invece di rilevare il punto perso di H. Se uno spazio tra caratteri è spostato, due gruppi validi più brevi possono sostituire una lettera prevista. Significato e confronto con la fonte restano quindi necessari anche quando non compare alcun avviso. Considera la validità come 'riconosciuto dalla mappa', non 'confermato dal mittente'.
Diversi segnali uniti si sovrappongono alla punteggiatura visualizzata. .-.-. normalmente si decodifica come +, ma la preferenza per i prosign lo rende <AR>. .-... normalmente si decodifica come lo schema aggiuntivo & e diventa <AS> con quella preferenza. L'opzione non modifica i segni di input né il loro audio; seleziona la rappresentazione testuale per un gruppo sovrapposto.
...-.- e ...---... uniti non hanno una voce di punteggiatura ordinaria in questa mappa, quindi si decodificano come <SK> e <SOS> anche con la preferenza disattivata. ... --- ... separato continua a rappresentare le tre lettere SOS. Allo stesso modo, .- .-. resta AR invece di diventare un prosign unito. Gli spazi dicono al decodificatore che le lettere erano separate.
UIT-R M.1677-1 fornisce significati procedurali e regole di trasmissione, non semplicemente una lista di etichette intercambiabili. I suoi segnali di attesa e fine lavoro aiutano a spiegare le convenzioni AS e SK usate qui. Include anche un segnale di errore a otto punti, un segnale di intesa e un segnale di inizio che non sono token supportati in questo strumento. Un gruppo a otto punti sarà quindi sconosciuto qui, anche se ha un ruolo definito nel documento. Non chiamare ogni gruppo sconosciuto privo di senso né ogni etichetta accettata una trascrizione operativa completa.
| Input unito | Preferenza disattivata | Preferenza attivata |
|---|---|---|
.-.-. | + | <AR> |
.-... | & | <AS> |
...-.- | <SK> | <SK> |
...---... | <SOS> | <SOS> |
Il decodificatore restituisce lettere maiuscole, cifre, É e punteggiatura mappata. Non conserva le maiuscole/minuscole della fonte e non traduce un messaggio nella lingua della pagina. Una spiegazione in russo non trasforma un gruppo Morse latino in un carattere cirillico. Alfabeti diversi o adattamenti nazionali possono usare alcuni degli stessi schemi; questo strumento applica la mappatura mostrata nella sua tabella.
Un separatore scritto di parola / è distinto dal gruppo di carattere -..-., che si decodifica come una barra letterale. Per una frazione o data copiata in Morse, conserva quel gruppo invece di sostituirlo con un separatore. La moltiplicazione condivide -..- con X e si decodifica come X. Il contesto del messaggio può suggerire un segno di moltiplicazione previsto, ma il convertitore non recupera la tipografia originale da un segnale identico.
La vista della punteggiatura contrassegna !, &, ;, _ e $ come schemi aggiuntivi, non come voci di punteggiatura nella tabella ITU citata. Un rompicapo può usarli deliberatamente, ma un altro strumento o una convenzione operativa può differire. Se un gruppo accettato restituisce punteggiatura inattesa, confronta la tabella e la fonte prima di riscriverlo. Percentuali e formattazione numerica operativa non sono interpretate automaticamente; una trascrizione leggibile non è un'espressione valutata né una coordinata convalidata.
Inizia dal passaggio contestato più piccolo e dalla sua fonte. Prima controlla se i segni sono stati copiati correttamente. Poi ispeziona gli spazi tra lettere e i veri separatori di parola. Quindi normalizza la tipografia accettata. Infine esamina il contesto procedurale e l'opzione prosign. Questo ordine separa un problema di input da una scelta di rappresentazione. Rieseguire la stessa riga danneggiata con impostazioni di velocità diverse non può riparare il testo, perché WPM influisce solo sulla riproduzione.
Dopo una correzione concordata, decodifica di nuovo il messaggio completo e confronta sia la parte appena riparata sia i suoi vicini. Un cambiamento di separatore può influire su più di una lettera. Se il risultato è destinato alla stampa, ripeti il controllo sulla grafica finale invece che solo su un file di testo intermedio. Se proviene da qualcun altro, conserva un'indicazione del materiale incerto invece di presentare silenziosamente una parola ipotizzata come confermata.
La riproduzione audio è un confronto opzionale dopo che tutti i gruppi sono validi. Per un controllo visivo di S rispetto a H, la tabella è di solito più rapida. Per distinguere A e N dal ritmo, prova la stessa velocità dei caratteri e lo stesso tono per entrambe. La riproduzione prova che una sequenza scritta riconosciuta può essere generata come toni; non prova che la tua trascrizione corrisponda a una registrazione, e non esiste un decodificatore automatico di input audio che faccia quel confronto per te.
Per metterti alla prova, Nascondi risposta è disponibile in modalità Morse in testo: prova a leggere il codice prima di mostrare la trascrizione. Casuale sostituisce l'input attuale con una parola di esercizio nella notazione scelta, quindi conserva prima l'originale. Copia e il download del testo mantengono la trascrizione, compresi i segnaposto [?]. PNG e WAV rappresentano invece il Morse inserito; il WAV richiede gruppi validi. Conserva l'originale come documentazione della fonte accanto alla trascrizione corretta se le modifiche devono poter essere verificate.
Il nastro del messaggio del 1844 conservato dalla Library of Congress mostra un messaggio registrato da Morse a Vail nel 1844. Gli operatori potevano lavorare da una registrazione fisica, mentre un sounder come il sounder telegrafico dello Smithsonian permetteva loro di interpretare impulsi elettrici tramite clic udibili. Entrambi richiedevano a una persona di identificare schemi e confini. Il decodificatore moderno digitato comincia dopo quell'identificazione: riceve gruppi espliciti, non un segnale reale ambiguo.
La distinzione spiega anche il valore degli esempi marittimi precedenti. Il Congressional Record del 1909 su Jack Binns registra le chiamate di soccorso CQD di Jack Binns nel 1909; il resoconto del Science Museum sulla radiotelegrafia del Titanic descrive come le chiamate e i messaggi del Titanic furono ricevuti da altre navi nel 1912. Uno schema di soccorso riconosciuto era solo una parte di uno scambio, che richiedeva anche informazioni identificative e operatori attenti. Queste storie non mostrano che una traduzione SOS isolata contenga tutto ciò che serve per una comunicazione utile.
Per un esempio visivo, la scheda dei National Archives sull'intervista a Denton documenta la parola TORTURE battuta con gli occhi durante un'intervista nel 1966. L'interpretazione umana di una registrazione temporizzata è diversa dall'inserimento qui di gruppi separati. Quando insegni con quell'episodio, distingui la prova storica, la tua trascrizione e il risultato del convertitore. Una trascrizione inventata o un campione audio generato non deve essere presentato come la registrazione originale.
... --- ... / .x-SOS [?]A–Z, cifre e punteggiatura standard seguono UIT-R M.1677-1. Cinque segni aggiuntivi sono indicati nella tabella. <AR>, <AS>, <SK> e <SOS> producono segnali uniti; il decoder può preferire questa lettura quando il modello coincide con la punteggiatura. Il ritmo usa unità 1/3/7. Farnsworth allunga solo le pause tra lettere e parole secondo la convenzione PARIS di 50 unità. Riproduzione, durata e WAV condividono la stessa sequenza temporale.
Non vengono usati microfono, ricevitore radio, fotocamera o torcia. I caratteri non supportati sono segnalati e omessi nella codifica; i gruppi Morse sconosciuti restano come [?] e bloccano la riproduzione. L’audio richiede un’API funzionante. Schermo e vibrazione possono ritardare; dispositivi sospesi o in background non sono trasmettitori affidabili. Nascondere la scheda interrompe il suono. Le sessioni non vengono salvate. Il link contiene il messaggio completo senza cifratura. La lettera accentata É è supportata anche nella forma Unicode decomposta. Il segno di moltiplicazione × usa il segnale di X e viene quindi decodificato come X: il solo segnale non permette di distinguerli. Le percentuali e gli altri formati numerici operativi non vengono sviluppati automaticamente.
Segnala pagina, input esatto, risultato atteso e impostazioni. Per problemi di ritmo indica entrambe le velocità. Confronta la tabella ufficiale prima di modificare un identificativo e rimuovi le informazioni private dalla segnalazione.
Controlla di aver incollato punti e linee, non parole ordinarie, e che ogni carattere abbia un confine di spazio. Ispeziona i segni tipografici non familiari prima di normalizzare. Se un gruppo non è nella mappa supportata, [?] conserva quell'incertezza; cambiare tono o velocità non cambierà il testo decodificato.
Non in modo univoco in generale. I gruppi Morse hanno lunghezza variabile, quindi un flusso continuo ammette divisioni diverse. Ripristina i confini dall'originale o chiedi al mittente una versione separata. Una frase plausibile ottenuta indovinando non è una decodifica verificata, anche se ogni gruppo ipotizzato è valido.
Una nuova riga viene normalizzata a confine di parola. È utile per codice scritto una parola per riga, ma non per una riga spezzata solo per adattarsi alla pagina. Rimuovi gli a capo editoriali mantenendo gli spazi effettivi tra caratteri e i separatori di parola. Conserva la versione originale se stai trascrivendo materiale storico.
No. Standardizza simboli e separatori accettati ma lascia un carattere non familiare come x in .x-. Eliminarlo creerebbe silenziosamente A. Confronta l'originale e correggi deliberatamente il refuso specifico; la normalizzazione non è un algoritmo generale di correzione degli errori.
..--.. è un punto interrogativo mappato e restituisce ?. [?] è il segnaposto dello strumento per un gruppo non riconosciuto. La distinzione consente a una trascrizione di contenere una domanda intenzionale senza farla sembrare un errore. Mantieni i segnaposto finché l'input corrispondente non è stato controllato.
Lo schema unito .-.-. si sovrappone al segno di addizione/croce e alla convenzione AR. Attiva la preferenza prosign quando la fonte lo usa in senso procedurale. L'opzione cambia l'interpretazione visualizzata, non il suono, e non può dire se il mittente intendesse aritmetica o un segnale di fine messaggio.
Il documento ITU lo definisce, ma questo strumento implementa solo la sua mappa visualizzata e i quattro token espliciti AR, AS, SK e SOS. Non è un parser completo di tutta la procedura operativa. Conserva l'originale e annota separatamente quel segnale procedurale invece di trattarlo come una lettera corrotta.
Sì. Un punto mancante può trasformare H in una S valida, e un separatore spostato può creare lettere valide ma non previste. L'avviso rileva gruppi sconosciuti, non deviazioni dal significato del mittente. Confronta il risultato con la fonte o ottieni una ripetizione quando il messaggio conta.
La trascrizione conserva gruppi riconosciuti e segnaposto, quindi è utile per l'indagine. La riproduzione richiede una sequenza temporale valida per ogni gruppo e rifiuta Morse non valido. Copiare SOS [?] non conferma il gruppo mancante; ripara l'originale prima di esportare un segnale audio completo.
No. Non ha analisi di registrazioni né ricezione da microfono. Puoi inserire una trascrizione manualmente separata e usare la tabella o la riproduzione generata come confronto. Mantieni documentati segni o pause incerti invece di presumere che lo strumento abbia recuperato dettagli mai forniti.