Étape 1
Choisir le mode correspondant
Composant décode les séparateurs ; URI entière conserve leurs séquences ; formulaire remplace aussi + par un espace.
Un passage enlève une couche et laisse l’original modifiable.
Un passage enlève une couche et laisse l’original modifiable.
Composant décode les séparateurs ; URI entière conserve leurs séquences ; formulaire remplace aussi + par un espace.
Les séquences incomplètes ou l’UTF-8 invalide donnent une erreur sans modifier l’entrée.
Copiez ou téléchargez le résultat. Examinez les séquences restantes sans décodage répété automatique.
Pour une requête copiée d’un journal, repérez d’abord les champs encodés. Dans q=A%26B&lang=en, q vaut A%26B; le décodage composant donne A&B. Décoder tout avant de séparer ferait ressembler cette esperluette interne à un nouveau séparateur.
Gardez le journal original et partagez des exemples fictifs. Le texte décodé peut révéler noms ou jetons. L’outil inspecte une valeur, ni une collection de champs ni la destination d’une redirection.
Comparez C++ et C%2B%2B. Composant conserve C++ pour les deux; formulaire transforme les plus littéraux en espaces, mais %2B en plus.
Identifiez la convention de l’émetteur avant le mode formulaire. Un espace inattendu ne prouve pas un espace original. L’avertissement sur + invite à enquêter, pas automatiquement à changer de mode.
Pour une valeur imbriquée, décodez %252F une fois vers %2F, puis identifiez la couche. Une seconde passe composant distincte donnerait /.
Ce peut être juste pour la valeur interne et faux pour l’adresse entière. Gardez chaque étape au lieu de continuer jusqu’à la lisibilité. Un texte lisible ne prouve ni signature, ni destination fiable, ni structure prévue.
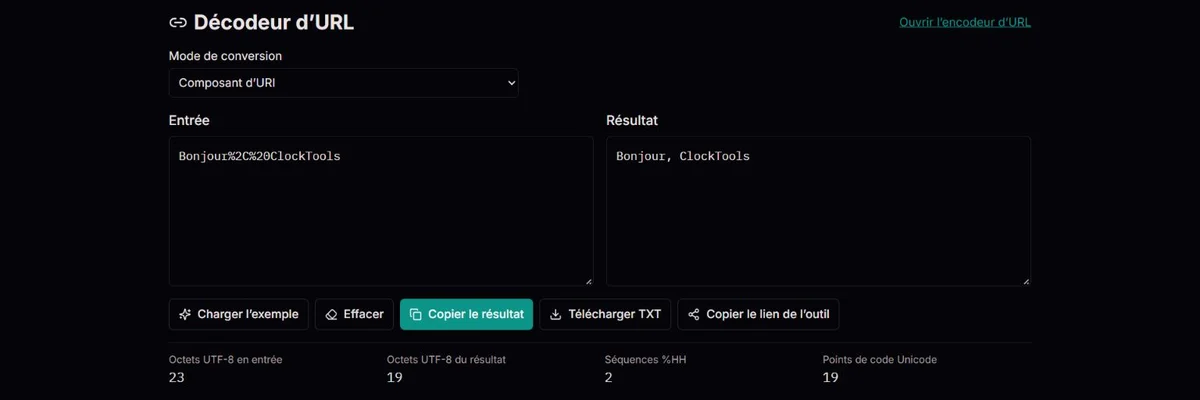
Composant décode les séquences réservées d’une valeur. URI entière garde celles que decodeURI traite comme structure. Formulaire remplace d’abord les + littéraux par des espaces, puis décode strictement. Choisissez la convention de l’émetteur, pas la sortie la plus familière.
Les modes traitent une chaîne, pas une collection analysée. Avec plusieurs champs, repérez les séparateurs encodés avant de décoder noms et valeurs. Un %26 interne ne doit pas devenir séparateur parce que la collection a été décodée trop tôt.
JavaScript définit l’ensemble préservé par decodeURI, dont barre oblique, esperluette et plus. %2F%26 reste donc visible en URI entière, tandis que composant donne /&. Des séquences conservées peuvent être une sortie correcte, pas un échec. ECMAScript decodeURI et les séquences préservées.
%252FEntrée imbriquée%2FAprès un seul passage/Après un second passage séparé%252F devient %2F, et non /. Le texte peut être volontairement imbriqué ou avoir été encodé deux fois par erreur. Il faut identifier la cause avant de corriger.
Décoder jusqu’à ce que rien ne change peut transformer des données en structure. Une barre oblique modifie les segments du chemin ; une esperluette peut séparer des champs.
decodeURI conserve %2F et %26 ; decodeURIComponent les décode dans une valeur. La norme recommande de respecter ces frontières plutôt que de supprimer indistinctement toutes les séquences. Conseils de décodage du RFC 3986.
Deux chiffres après % ne suffisent pas : %C3%A9 représente é, mais %C3%28 n’est pas de l’UTF-8 valide. Aucun symbole de remplacement n’est inséré pour cacher l’erreur.
Les données anciennes peuvent employer un autre encodage. Cet outil ne détecte pas le jeu de caractères et ne décode pas Latin-1. Retrouvez l’encodage d’origine.
En mode formulaire, + devient un espace avant le décodage, donc %2B reste un vrai plus. Contrairement à l’analyseur tolérant WHATWG, ce décodeur rejette les octets UTF-8 invalides. Ordre d’analyse des formulaires WHATWG.
La table compare la même entrée de type formulaire. %2B devient plus en composant/formulaire; seul un + littéral devient espace en formulaire. L’ordre préserve la différence. URI entière garde %2B parce que plus appartient à l’ensemble préservé.
Le compteur de séquences décrit l’entrée. Octets et points de code de sortie décrivent le texte décodé, pas les glyphes visibles. caf%C3%A9 donne café : deux séquences représentent les deux octets de é; la sortie a cinq octets UTF-8 et quatre points de code. Sortie vide avec erreur n’est pas une valeur vide réussie.
L’exemple remplace l’entrée et Effacer la retire. Copie et TXT portent sur le résultat et sont indisponibles sans sortie. Le lien de l’outil partage seulement la page; celui de l’encodeur ne transfère pas le texte. Conservez original et mode pour comparer un aller-retour.
| Entrée | Mode | Résultat |
|---|---|---|
| caf%C3%A9 | Composant d’URI | café |
| A%2BB+C | Valeur de formulaire | A+B C |
| A%2BB+C | Composant d’URI | A+B+C |
| %2F%26 | URI entière | %2F%26 |
| %252F | Composant d’URI | %2F |
| %C3%28 | Composant d’URI | Erreur UTF-8; aucune sortie |
La ligne d’erreur n’est pas un résultat partiel. Aucun exemple ne visite ni ne certifie une adresse.
Un %, %2 ou %GG final échoue au contrôle syntaxique. Un signe % littéral dans des données encodées nécessite %25; tous les remplacer masquerait des séquences valides. Examinez la source ou demandez à l’émetteur plutôt que de deviner une correction.
%E9 est syntaxiquement correct mais ne représente pas é en UTF-8 seul; %C3%A9 le peut. %C3%28 et %FF sont également refusés malgré deux chiffres par séquence. L’erreur stricte révèle un problème d’octets. Ce n’est ni un décodeur Latin-1 ni un détecteur de charset.
Si %2F demeure, distinguez préservation par URI entière et signe % encodé dans une couche extérieure. Vérifiez mode et original avant une autre passe. Dans un mélange texte/séquences, un % nu peut faire échouer tout le résultat; l’entrée demeure modifiable, sans sortie partielle.
Si copie ou export échoue, utilisez le résultat visible et l’autre action disponible. Ne transmettez pas de redirections privées ou identifiants secrets. Décoder ne vérifie ni hôte, signature, accessibilité ou confiance, et la page n’ouvre jamais l’adresse.
Les séquences sont contrôlées avant un passage strict de décodage JavaScript. Le mode formulaire normalise d’abord les plus. Une erreur ne produit aucun résultat partiel et conserve la saisie.
Le résultat ne prouve ni sécurité ni accessibilité. Aucun lien n’est suivi ; les signatures, formulaires complets et encodages autres que UTF-8 ne sont pas traités.
Corrigez la séquence d’origine ou demandez du texte UTF-8 valide. Signalez un exemple fictif et le mode, jamais une redirection privée. Testez la correction côté destinataire.
Ce mode conserve les délimiteurs réservés. Utilisez composant pour décoder une valeur.
Seul le mode formulaire interprète un plus littéral comme un espace.
Non. Chaque passage retire une couche seulement.
E9 seul n’est pas UTF-8 valide pour é; UTF-8 utilise C3 A9. Un autre outil peut supposer un ancien charset ou remplacer les octets. Retrouvez l’encodage original plutôt que de prendre une lettre lisible pour preuve. Ici, seul UTF-8 strict est prévu.
Syntaxe et UTF-8 sont deux contrôles distincts. C3 commence une séquence multioctet; 28 n’est pas un octet de continuation valide. Le résultat est une erreur sans sortie partielle, l’original restant modifiable pour examiner l’octet absent ou altéré.
Non. %26 peut devenir & et un faux séparateur. Repérez d’abord les frontières encodées, puis décodez chaque valeur selon sa convention. La page n’effectue pas cette analyse structurée et ne compose pas de requête corrigée.
Vérifiez le statut. Entrée vide et entrée erronée donnent toutes deux une sortie vide, mais la seconde affiche une erreur. L’original reste corrigeable et copie/export sont désactivés. Une erreur ne signifie pas que des caractères indésirables ont été nettoyés.
Cet outil décode les séquences %HH ; ce n’est pas un décodeur généraliste. & et Base64 ne sont pas interprétés selon ces encodages. Retrouvez le format et utilisez l’outil correspondant; une chaîne inchangée ne prouve pas qu’elle était encodée à l’aide de séquences %HH.