Étape 1
Choisir une destination autorisée
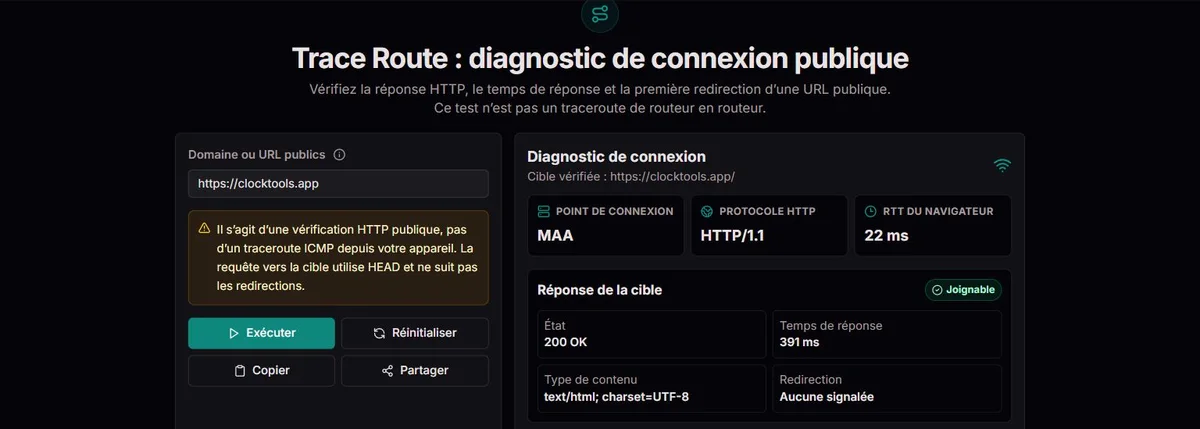
Exemple illustratif, pas un résultat en direct
https://clocktools.app/Saisissez une URL HTTP ou HTTPS publique, sans identifiants ni port personnalisé.
Distinguez la connexion du navigateur et une requête HTTP extérieure. Consultez délais et redirections sans inventer de sauts de routeurs.
Distinguez la connexion du navigateur et une requête HTTP extérieure. Consultez délais et redirections sans inventer de sauts de routeurs.
https://clocktools.app/Saisissez une URL HTTP ou HTTPS publique, sans identifiants ni port personnalisé.
Navigateur → service → cibleLe trajet du navigateur vers le service et celui du service vers la cible sont différents.
JSONExportez le résultat daté puis comparez-le à un test local dans un navigateur ou un terminal.
Votre ordinateur n’ouvre pas un site public, mais la vérification extérieure reçoit une réponse. Gardez protocole, hôte et chemin identiques en comparant un autre navigateur ou réseau. Testez d’abord anonymement, puis DNS, VPN, extensions et règles une à une. La réponse réduit le champ d’enquête, sans certifier tous les visiteurs.
Après un déplacement de page, testez l’ancienne URL et lisez première réponse et Location. Une redirection explique parfois l’adresse du navigateur, mais l’outil s’arrête là. Vérifiez la destination séparément si vous y êtes autorisé. Gardez les deux observations dans le ticket, sans déclarer la page finale déjà vérifiée.
Pour un incident intermittent, exportez JSON avec URL, heure, statut, durée approximative et contexte navigateur-service. Ajoutez l’échec local et le réseau utilisé. Si le support demande des sauts routeurs ou pertes répétées, fournissez des mesures terminal autorisées séparées ; les étapes ici ne les remplacent pas.
Les routeurs IPv4 diminuent le TTL lors du transfert. Lorsqu’il s’épuise, un message ICMP de dépassement de durée peut identifier le routeur répondant. Un traceroute en terminal fait varier les limites des sondes et collecte les réponses.
Cette page n’envoie aucune sonde à TTL variable. Le délai HTTP comprend la requête extérieure et le travail du service. Le RTT TCP client, s’il est fourni, concerne une autre connexion. Aucun de ces nombres n’est un nombre de sauts ou un ping pur vers la cible. Spécification ICMP.
Les exigences des routeurs décrivent TTL et transfert, mais les chemins et réponses varient. Même un traceroute peut avoir des blancs si les appareils filtrent ou limitent les réponses. Ces blancs ne prouvent pas une perte de paquets dans l’application.
Une réponse HTTP 403 ou 500 reste une réponse observée. Un délai dépassé signifie seulement qu’aucune réponse exploitable n’est arrivée à temps. Comparez URL, méthode et instant : le GET du navigateur peut différer du HEAD utilisé ici. Exigences des routeurs IPv4.
Supposons un HEAD extérieur répondant 403 en 240 ms, alors que votre navigateur connecté ouvre la page. Il s’agit d’une différence d’accès, pas d’un routeur en panne. Le contrôle ne transmet pas vos cookies ; comparez accès anonyme et règles du pare-feu.
Saisissez la véritable URL HTTP ou HTTPS publique à examiner. Protocole et chemin comptent : HTTP peut rediriger, HTTPS répondre directement ; l’accueil peut fonctionner tandis qu’un chemin échoue. Ce n’est pas un scanner de ports : identifiants, destinations privées et ports personnalisés sont refusés. Utilisez une adresse ordinaire sans secret, pas un lien de réinitialisation ou téléchargement signé.
Aucun réglage ne choisit nombre de sauts, taille de paquet, nombre de sondes ou méthode. La requête extérieure utilise HEAD sans suivre les redirections. Elle demande des en-têtes, pas un téléchargement de page. La sémantique des méthodes HTTP distingue HEAD et GET ; une visite normale récupère le contenu puis d’autres ressources que ce test ne demande pas.
Lancez, attendez et exportez avant de changer les conditions. Annuler ou réinitialiser lors d’un changement de cible empêche un ancien résultat de remplacer la vue. Le partage préremplit une nouvelle vérification volontaire, pas les mesures. Un nouveau résultat peut légitimement différer avec le temps, le réseau ou la cible.
La première observation concerne la connexion qui apporte votre requête à ClockTools. Protocole HTTP, TLS et RTT TCP client, lorsqu’il est fourni, décrivent ce trajet. La seconde est une requête anonyme distincte du service vers la cible. Les étapes organisent ces observations, sans cartographier les routeurs entre votre ordinateur et le site.
La durée mesurée pour la cible comprend la vérification du DNS public et la requête externe jusqu’à la réception d’une réponse. Elle ne mesure ni le seul traitement du serveur, ni le débit, ni le chargement de la page, ni un aller-retour ICMP vers la cible. N’en soustrayez pas le RTT du navigateur, n’additionnez pas les deux valeurs pour obtenir un « ping total » et ne divisez pas cette durée par le nombre d’étapes pour en déduire des latences. Les points de terminaison et les périmètres de ces mesures sont différents.
Dans l’exemple fixe, 18 ms vers le service et 240 ms vers la cible ne désignent aucun lien lent. DNS, connexion, contrôle d’accès et réponse contribuent à la seconde valeur. Une donnée absente reste inconnue. Un lieu de service ne prouve ni trajet physique, ni position exacte du client, ni origine derrière un proxy.
Une étape terminée signifie réponse reçue, pas page fonctionnelle. Lisez ensuite le code. 200 concerne cette requête HTTP, pas affichage, connexion ou paiement réussi. 403 et 500 prouvent aussi une réponse et orientent vers accès ou application, plutôt que vers « aucun serveur joignable ».
301 ou 302 ne décrit que la première redirection. Location peut être relative : interprétez-la avec l’URL vérifiée. L’outil ne confirme pas que la suite est sûre, joignable ou sans boucle. Gardez la réponse initiale et examinez séparément la destination publique prévue si vous êtes autorisé.
Un serveur peut traiter HEAD autrement que GET malgré la relation prévue par le protocole. Avec 405 ou 501 et un navigateur fonctionnel, demandez si la méthode est acceptée ou bloquée. Une sonde anonyme peut aussi recevoir un contrôle alors qu’un navigateur connecté voit le contenu. Ces différences justifient une comparaison, pas le contournement des règles.
| Résultat | Observation | Suite utile |
|---|---|---|
| 200 | Réponse réussie à HEAD | Vérifier séparément page et interactions. |
| 301 / 302 | Redirection initiale | Lire Location et vérifier ensuite la destination. |
| 401 / 403 | Authentification ou refus | Comparer accès anonyme et règles du propriétaire. |
| 404 | Ce chemin n’a pas été trouvé | Vérifier orthographe et chemin public connu. |
| 405 / 501 | Méthode refusée ou non prise en charge | Comparer un GET autorisé et la gestion des méthodes. |
| 429 / 5xx | Limite ou réponse serveur | Suspendre les essais et consulter les journaux compétents. |
Sans réponse HTTP exploitable, commencez par l’erreur, pas la durée. DNS non trouvé invite à vérifier nom et résolution. DNS indisponible signifie plus prudemment que le contrôle du résolveur n’a pas établi de réponses publiques utilisables. Aucun ne teste l’expiration. Pour votre domaine, comparez A, AAAA et délégation avec les outils d’administration habituels.
Le test extérieur dispose d’environ 6,5 secondes au total, DNS compris. Un délai dépassé indique seulement qu’aucune réponse exploitable n’est arrivée à temps. Il n’isole pas un routeur, ne prouve pas un serveur arrêté et ne mesure pas les pertes. Connexion ou TLS peuvent également produire une erreur sans code HTTP. Journaux cible et test indépendant autorisé sont nécessaires pour la cause.
Si local et extérieur divergent, gardez URL exacte et heure. Essayez un navigateur anonyme, puis un autre réseau disponible. Changez une seule variable : réseau, VPN, navigateur ou méthode. Si les deux échouent, transmettez les observations sans proclamer une panne mondiale. Un point extérieur n’est pas une surveillance multirégion.
Un traceroute classique envoie des sondes avec des limites de durée de vie croissantes et associe leurs réponses. La spécification ICMP décrit les messages Time Exceeded ; IPv6 utilise Hop Limit dans son en-tête de base. Ce mécanisme est différent d’une requête d’en-têtes HTTP. ClockTools ne produit pas ces sondes ni une liste de routeurs reconstruite.
Utilisez un outil terminal local adapté et une cible autorisée pour mesurer les sauts qui répondent. Notez réseau source et type de sonde ; un autre ordinateur ne fournit pas forcément votre trajet. Séparez cette sortie du JSON pour que le support distingue sondes de paquets et réponses applicatives.
Même le terminal demande une lecture prudente. Un équipement peut ignorer les sondes tout en transférant le trafic normal ; chemins et réponses peuvent varier. Un saut intermédiaire silencieux ne prouve pas une perte applicative à cet endroit. Partez du problème visible, comparez la destination et répétez les mesures autorisées si nécessaire. Les étapes ici ne révèlent ni routeurs, ni distances, ni fournisseurs responsables.
Le rapport sépare connexion navigateur-service, vérification DNS publique récente et HEAD anonyme vers la cible. Il conserve première réponse, en-têtes choisis et durée approximative sans suivre les redirections. Les champs absents restent inconnus. JSON garde l’heure ; annuler et réinitialiser empêchent les résultats tardifs de remplacer la vue.
Aucun saut routeur, latence par saut, perte de bout en bout ou traceroute terminal n’est mesuré. Une observation extérieure n’est pas un contrôle mondial, un benchmark de chargement ou une surveillance continue. Seules les cibles publiques sont acceptées. Une erreur doit être lue avec URL, méthode et heure ; elle ne désigne pas seule une couche défaillante.
Signalez un problème reproductible via la page Contact en indiquant l’URL de l’outil, une entrée non confidentielle, l’heure de vérification, le résultat attendu et la preuve source. Joignez si possible la réponse publique, sans données de compte ni lien secret. Une modification de la source n’est pas forcément une erreur de calcul. Comparez le même nom, la même page et le même instant.
Non. Il sépare connexion à ClockTools et vérification HTTP extérieure. Les étapes ne sont pas des routeurs. Pour mesurer les sauts répondants, utilisez traceroute ou tracert autorisé depuis le réseau concerné et gardez ces résultats à part.
Terminée signifie qu’une réponse HTTP est arrivée. Refus et erreur serveur restent des réponses, pas une absence de connectivité. Examinez code, règles et journaux. Le rapport ne confirme pas le fonctionnement de la page prévue ou du parcours utilisateur.
Non. Première réponse et Location éventuel sont affichés ; la destination n’est pas vérifiée. Résolvez une valeur relative avec l’URL initiale et examinez la destination publique séparément avant de parler de parcours complet réussi.
Le navigateur peut utiliser GET, cookies, cache ou autre réseau, contre HEAD anonyme extérieur ici. Comparez la même URL anonymement et les règles de méthode et d’accès. Un 405 ou une page de contrôle peut expliquer la différence sans panne de routage.
Non. Il comprend DNS et opération HTTP extérieure. Le RTT TCP navigateur décrit une autre connexion à ClockTools. Ni l’un ni l’autre n’est un ping ICMP cible, et les additionner ou soustraire ne crée pas une mesure de bout en bout.
Seulement l’absence de réponse exploitable pendant les quelque 6,5 secondes de ce test. DNS, connexion, contrôle d’accès et cible peuvent intervenir. Gardez erreur et heure puis comparez un test indépendant autorisé ; aucun routeur défaillant n’est identifié.
Non. Les cibles HTTP ou HTTPS publiques sur ports standards sont acceptées. Adresses privées, identifiants et ports personnalisés sont refusés. Utilisez les outils locaux autorisés de votre organisation pour l’interne, sans contourner la limite avec un autre nom.
Non. C’est une observation à un instant. Réseaux et politiques d’accès peuvent différer. Comparez des réseaux indépendants et la surveillance de l’opérateur avant une affirmation plus large, et joignez les conditions du test au ticket.
Non. Le lien prépare une nouvelle vérification volontaire. Copiez ou exportez JSON pour l’ancienne observation. Partager ou laisser la page ouverte ne crée pas de surveillance ; les conditions et l’heure d’un autre utilisateur peuvent produire un autre résultat.