Étape 1
Coller les deux versions
limit = 8
     →
limit = 12
Placez l’original à gauche et la révision à droite, sans oublier la dernière ligne.
Comparez lignes, mots ou caractères, normalisez explicitement Unicode et les fins de ligne, puis exportez un correctif exact.
Comparez lignes, mots ou caractères, normalisez explicitement Unicode et les fins de ligne, puis exportez un correctif exact.
limit = 8
→
limit = 12Placez l’original à gauche et la révision à droite, sans oublier la dernière ligne.
8  ≠  12

CRLF  ≠  LF
Lignes pour la structure, mots pour la rédaction, caractères pour la ponctuation. Activez seulement les exclusions pertinentes.
- limit = 8
+ limit = 12
  retry = true
Vérifiez suppressions et ajouts côte à côte ou ensemble. Le correctif téléchargé décrit les entrées exactes.
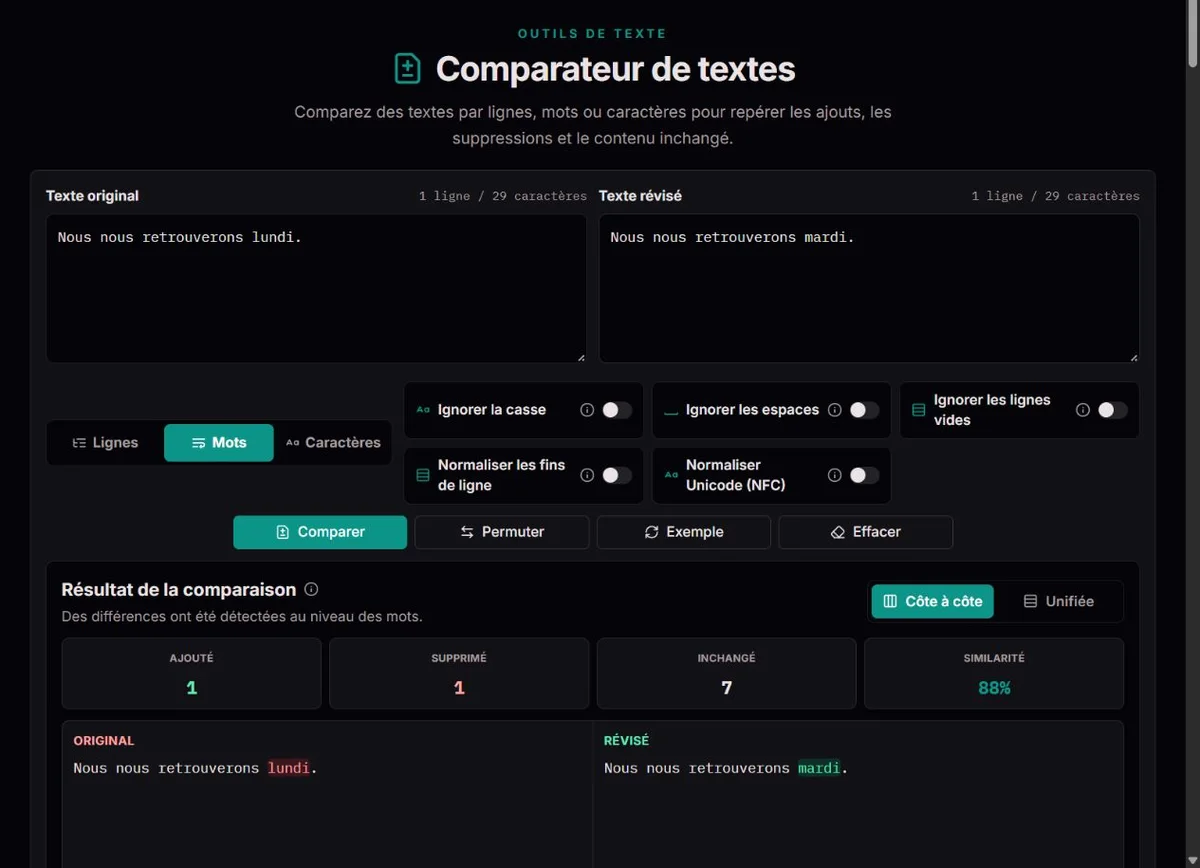
Comparez une annonce et sa révision en mode Mots, sans règles d'exclusion. Relisez une date modifiée ou le passage de peut à fera dans le contexte ; utilisez ensuite Caractères pour la ponctuation. La vue séparée facilite la lecture intégrale. Un pourcentage élevé peut contenir l'unique changement déterminant ; il n'accorde pas une validation éditoriale.
Choisissez Lignes pour un petit bloc et conservez les espaces lorsque l'indentation compte. Si un transfert entre systèmes change toutes les lignes, testez séparément la normalisation des fins de ligne. Gardez le patch brut pour la revue, puis validez le fichier révisé avec son parseur ou ses tests. Le comparateur n'analyse pas YAML, JSON, SQL ou le code.
Comparez exactement deux libellés visuellement égaux en Caractères, puis activez seulement NFC. Si l'écart d'accent disparaît, sa représentation canonique était en cause. Testez les fins de ligne séparément. Aucun réglage n'élimine tous les caractères invisibles ou ressemblants ; réduisez l'exemple avant de conclure à une erreur d'affichage.
- limit = 8
+ limit = 12
  retry = true
Un diff décrit une modification plutôt que deux documents entiers. La documentation GNU du format unifié explique le format compact qui présente les lignes modifiées avec leur contexte proche.
Le contexte aide à situer l’édition. Le fichier nomme original.txt et revised.txt et décrit des lignes même lorsque l’affichage compare les mots.
Des lignes répétées permettent plusieurs alignements. Le moteur trouve une suite d’éditions, pas l’intention de l’auteur. Vérifiez le contexte d’une phrase déplacée.
Une lettre accentuée peut être un point de code ou une lettre suivie d’une marque combinante. La spécification Unicode sur la normalisation définit l’équivalence canonique. NFC ne modifie que la comparaison, pas les champs.
CRLF et LF diffèrent. L’option correspondante traite CRLF et CR isolé comme LF. Ignorer les lignes vides retire aussi leurs informations de séparation.
La similarité vaut deux fois les unités inchangées divisées par le total des deux versions. Elle dépend des unités et exclusions : ce n’est ni une mesure du sens ni une preuve de plagiat ou de justesse.
Le mode Lignes traite une ligne complète avec sa terminaison comme une unité. C'est pratique pour listes, journaux, plans, sous-titres et configurations, mais un mot remplacé peut colorer toute la ligne. Le mode Mots suit la segmentation du moteur de comparaison pour le texte, la ponctuation et les espaces significatifs. Selon le système d’écriture et la ponctuation, un mot peut être divisé en fragments ; les totaux comptent ces unités de comparaison, pas des mots au sens linguistique. Le mode Caractères convient aux décimales, URL, identifiants et petites corrections.
Commencez par la structure, puis zoomez sur l'édition incertaine. Un paragraphe déplacé peut être supprimé puis ajouté ailleurs, sans reconnaissance de déplacement. Des lignes identiques répétées autorisent plusieurs alignements plausibles : relisez le contexte. Le comparateur examine deux chaînes collées, sans historique de dépôt, fusion à trois voies, commentaires ni compréhension de l'intention.
Toutes les règles commencent désactivées. Examinez d'abord la comparaison exacte, puis activez une seule option. Ignorer la casse utilise la minuscule, pas une collation linguistique. Ignorer les lignes vides supprime les lignes de seuls espaces et rejoint le reste avec LF : des écarts de terminaison ou de frontière finale peuvent aussi disparaître. Ce n'est pas seulement masquer des rangées à l'écran.
En Lignes, ignorer les espaces retire les marges et réduit espaces ou tabulations ; cela peut cacher l'indentation et même une différence de terminaison. En Mots, les séquences deviennent un espace. En Caractères, elles disparaissent entièrement : a b peut correspondre à ab. Ne cherchez pas un meilleur score ; décidez si les distinctions supprimées sont réellement sans importance.
| Exemple | Réglage | Conséquence |
|---|---|---|
| LF / CRLF | Normaliser les fins de ligne | CRLF et CR seul deviennent LF pour comparer, sans modifier les éditeurs. |
é / e + U+0301 | NFC | Équivalence canonique possible ; l'accent n'est pas supprimé. |
Label / label | Ignorer la casse | Cache les majuscules, parfois essentielles au code ou aux noms. |
a b / ab | Caractères + ignorer les espaces | Cache le séparateur, mais les textes bruts diffèrent. |
Original à gauche, révision à droite : moins/rouge indique une suppression, plus/vert un ajout. Neutre signifie égal sous les règles choisies, pas nécessairement identique octet par octet. La vue séparée conserve les côtés ; la vue unifiée entrelace les changements. Permuter inverse la direction et transforme ajouts en suppressions, sans décider quelle version est préférable.
Exemple reproductible en Lignes sans exclusions : limit = 8 devient limit = 12, chaque version ayant un saut de ligne puis retry = true et son saut final. On compte une ligne retirée, une ajoutée et une inchangée. Similarité : 50 %, soit 2 × 1 / (2 + 2). Les modes Mots ou Caractères utilisent d'autres unités et donnent un autre score pour la même révision.
Copier et télécharger le diff produisent un patch unifié, par lignes, des entrées brutes, nommé original.txt et revised.txt. NFC, normalisation des fins de ligne et exclusions ne le réécrivent pas. Un écran normalisé peut donc sembler identique tandis que le patch conserve une modification de représentation. Notez les réglages pour expliquer cette distinction à un autre lecteur.
L'en-tête nomme les fichiers avant/après ; chaque bloc indique les plages de lignes affectées. Un espace initial signifie contexte, moins une ancienne ligne et plus une nouvelle. L'absence de saut final peut aussi être signalée. Un patch décrit une transformation, pas un commit enregistré. Avant application ailleurs, contrôlez cible et version de départ : cette page n'applique pas les patches et ne résout pas les conflits.
Une erreur signifie calcul non terminé, pas textes identiques. Chaque entrée est limitée à 50 000 unités UTF-16 ; une suite d'éditions difficile peut dépasser le budget même en dessous. Le patch a son propre calcul borné et peut manquer aussi. Découpez les grands textes par sections pertinentes avec assez de contexte. Ne prenez pas un score affiché en état d'erreur pour un résultat.
Vérifiez les deux collages complets, désactivez les règles et comparez un fragment en Caractères. NFC n'assimile pas guillemets droits et courbes, espaces ordinaires et insécables, lettres latines et cyrilliques ressemblantes. Les unités sont des points de code, pas des emoji ou graphèmes entiers. Pour tableaux, mise en forme, commentaires ou encodages binaires, revenez au document original ou à un outil de comparaison de fichiers.
La comparaison locale limite chaque champ à 50 000 unités de chaîne JavaScript et borne le travail de calcul. Les lignes peuvent réduire les espaces, les mots normaliser les blancs et les caractères les retirer.
L’affichage peut masquer des différences ignorées, mais le correctif garde les entrées brutes. Les caractères sont des points de code Unicode, pas toujours des graphèmes visibles complets. Les grandes modifications peuvent atteindre la limite de calcul. Aucune validation de sécurité ou de syntaxe n’est faite.
Désactivez les exclusions, vérifiez les entrées et comparez une section plus petite. Pour signaler un problème, fournissez un exemple fictif court, l’unité et les réglages de normalisation.
Non. Il décrit exactement les entrées, y compris les différences masquées à l’écran.
Non. Il est affiché comme du texte et comparé littéralement.
Les limites de longueur et de travail protègent la réactivité. Découpez les documents en sections pertinentes.
NFC couvre l'équivalence canonique, pas toutes les ressemblances visuelles. Lettres confusables, espaces insécables, caractères sans largeur et guillemets peuvent rester distincts. Comparez exactement un petit fragment et inspectez ses points de code si nécessaire. N'effacez pas aveuglément des caractères invisibles dans le code ou les identifiants.
Oui : négation, date, point décimal ou permission peut compter davantage que des milliers d'unités inchangées. Le score décrit l'alignement et les règles, pas la qualité sémantique, le plagiat ou une approbation. Relisez chaque changement qui affecte le but du texte.
Le résultat décrit des ajouts et suppressions, pas une opération sémantique de déplacement. Un paragraphe peut disparaître ici et être ajouté ailleurs. Les répétitions compliquent l'alignement. Examinez les paragraphes voisins en vue séparée et l'ordre final ; une zone colorée n'est pas forcément du texte nouvellement rédigé.
Les entrées restent dans la mémoire de la page, sans restauration après rechargement. Partager ouvre l'outil sans inclure les textes. Conservez originaux ou export avant de quitter. Le patch révèle leurs changements : traitez ce fichier avec les mêmes précautions que le contenu comparé.
Sans exclusions, l'autre côté est entièrement ajouté ou supprimé. Deux entrées vides donnent 100 % par convention, pas une revue réussie. Une règle peut retirer le seul contenu composé d'espaces. Vérifiez les entrées et l'état du calcul avant d'interpréter un résultat vide.