Paso 1
Elige el modo correspondiente
Componente decodifica separadores; URI completa conserva sus escapes; formulario convierte + en espacio.
Una pasada elimina una capa y conserva el original editable.
Una pasada elimina una capa y conserva el original editable.
Componente decodifica separadores; URI completa conserva sus escapes; formulario convierte + en espacio.
Los escapes incompletos y el UTF-8 inválido producen un error sin cambiar la entrada.
Copia o descarga el resultado. Investiga los escapes restantes sin decodificarlos repetidamente de forma automática.
En una consulta de registro, identifica primero campos codificados. En q=A%26B&lang=en, q vale A%26B; componente produce A&B. Decodificar todo primero haría parecer el ampersand interno otro separador.
Guarda el original y comparte muestras ficticias. El texto revela nombres o tokens. La página inspecciona un valor, no una colección de campos ni el destino de una redirección.
Compara C++ con C%2B%2B. Componente da C++ en ambos; formulario convierte los más literales en espacios pero %2B en más.
Determina la convención del emisor antes de cambiar. Un espacio inesperado no prueba un espacio original. La advertencia de + pide investigar, no cambiar automáticamente a formulario.
Para un valor anidado, decodifica %252F una vez a %2F y determina la capa. Una segunda pasada componente separada produciría /.
Puede ser correcto para un valor interior e incorrecto para toda la dirección. Guarda cada etapa en vez de continuar hasta la legibilidad. Leerlo no valida firma, destino ni ruta previstos.
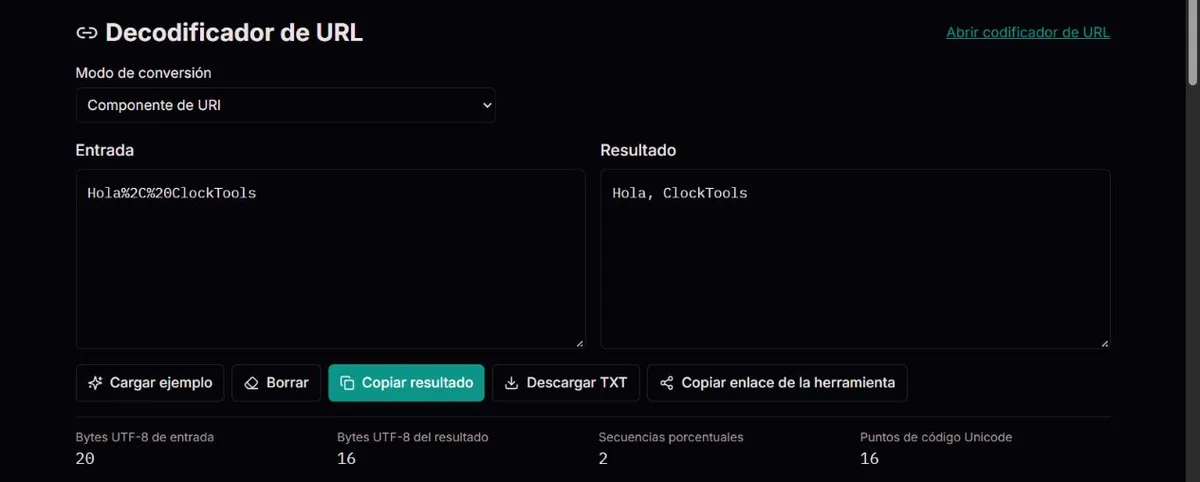
Componente decodifica escapes reservados del valor. URI completa conserva los que decodeURI trata como estructura. Formulario sustituye primero + literales por espacios y después decodifica estrictamente. Elige la convención del emisor, no la salida más familiar.
Se procesa una cadena, no una colección analizada. Para varios campos identifica separadores codificados antes de decodificar nombres y valores. Un %26 interno no debe convertirse en separador por haber decodificado toda la colección demasiado pronto.
JavaScript define el conjunto preservado de decodeURI, incluidas barra, ampersand y más. %2F%26 permanece en URI completa mientras componente da /&. Mantener secuencias puede ser el resultado correcto, no un fallo. ECMAScript decodeURI y conjunto de escapes preservados.
%252FEntrada anidada%2FDespués de una pasada/Después de otra pasada independiente%252F pasa a %2F, no a /. Puede tratarse de un valor anidado intencionadamente o de una doble codificación errónea. Primero hay que distinguirlos.
Decodificar hasta que nada cambie puede transformar datos en estructura. Una barra altera segmentos y un ampersand separa campos. Conserva el original y averigua las capas esperadas.
decodeURI conserva %2F y %26; decodeURIComponent los recupera dentro de un valor. La norma explica por qué no se deben borrar indiscriminadamente esos límites. Orientación sobre decodificación del RFC 3986.
Dos dígitos después de % no bastan. %C3%A9 representa é; %C3%28 no es UTF-8 válido. No se insertan símbolos de sustitución que oculten el problema.
Los datos antiguos pueden usar otro juego de caracteres. Esta herramienta no detecta codificaciones ni interpreta Latin-1. Obtén la codificación original.
En formulario, + se sustituye antes de decodificar, de modo que %2B sigue siendo un signo más. A diferencia del analizador tolerante WHATWG, aquí los bytes UTF-8 inválidos se rechazan. Orden de análisis de formularios WHATWG.
La tabla compara la misma entrada similar a formulario. %2B pasa a más en componente/formulario; solo un + literal pasa a espacio en formulario. El orden preserva esa distinción. URI completa mantiene %2B porque más pertenece al conjunto preservado.
El contador de escapes describe la entrada. Bytes y puntos de código de salida describen texto decodificado, no glifos. caf%C3%A9 da café: dos escapes representan los dos bytes de é; la salida tiene cinco bytes UTF-8 y cuatro puntos. Una salida vacía con error no es un valor vacío correcto.
El ejemplo reemplaza entrada; Borrar la elimina. Copia y TXT usan resultado y están desactivados sin salida. El enlace comparte página sola y el del codificador no transfiere entrada. Conserva original y modo para comparar ida y vuelta.
| Entrada | Modo | Resultado |
|---|---|---|
| caf%C3%A9 | Componente URI | café |
| A%2BB+C | Valor de formulario | A+B C |
| A%2BB+C | Componente URI | A+B+C |
| %2F%26 | URI completa | %2F%26 |
| %252F | Componente URI | %2F |
| %C3%28 | Componente URI | Error UTF-8; sin salida |
La fila errónea no es texto parcial. Ningún ejemplo visita ni certifica una dirección.
Un %, %2 o %GG final falla la sintaxis. Un signo de porcentaje literal necesita %25; sustituir todos indiscriminadamente ocultaría escapes válidos. Revisa fuente o emisor, no adivines la corrección de una cadena incompleta.
%E9 es sintácticamente correcto pero solo no representa é en UTF-8; %C3%A9 sí. %C3%28 y %FF también se rechazan aunque cada escape tenga dos dígitos. El error estricto evidencia un problema de bytes. No es un decodificador Latin-1 ni detector de charset.
Si queda %2F, distingue entre la conservación de escapes en URI completa y un signo % codificado en una capa exterior. Comprueba modo y original antes de otra pasada. Un % suelto en texto mixto puede fallar toda la conversión; entrada sigue editable y no se produce texto parcial.
Si fallan copia o exportación, usa resultado visible y otra acción disponible. No envíes redirecciones privadas o credenciales en reportes. Decodificar no verifica host, firma, acceso o confianza, y la página nunca abre la dirección.
Se comprueban los escapes antes de una pasada estricta de JavaScript. Formulario normaliza primero los signos más. Un error no genera resultados parciales ni reemplaza la entrada.
El resultado no demuestra seguridad ni accesibilidad. No se siguen enlaces ni se validan firmas, formularios completos o codificaciones distintas de UTF-8.
Corrige la secuencia original o solicita UTF-8 válido. Comunica modo y ejemplo ficticio, sin redirecciones privadas. Prueba la corrección con el receptor.
Este modo conserva delimitadores reservados; usa componente para un valor.
Solo formulario interpreta el signo más literal como espacio.
No. Cada pasada elimina una sola capa.
E9 solo no es UTF-8 válido para é: se usa C3 A9. Otro decodificador puede suponer un charset antiguo o reemplazar bytes. Averigua la codificación original en vez de tomar una letra legible como prueba. Aquí solo se admite UTF-8 estricto.
Sintaxis y UTF-8 son comprobaciones distintas. C3 inicia una secuencia multibyte; 28 no es continuación válida. Se devuelve error sin salida parcial y se conserva el original editable para investigar el byte ausente o modificado.
No. %26 puede volverse & y un separador falso. Identifica primero límites codificados y decodifica cada valor según convención. No se realiza ese análisis estructurado ni se construye una consulta corregida aquí.
Revisa estado. Entrada vacía produce vacío; sintaxis o UTF-8 erróneos también, pero con error. Original sigue corregible y copia/exportación quedan desactivadas. Un error no significa limpieza de caracteres indeseados.
Es un decodificador porcentual, no selector general de formatos. & y Base64 no se interpretan como tales. Obtén el formato real y usa su herramienta; permanecer igual no demuestra que una cadena estuviera codificada porcentualmente.