Paso 1
Pegar ambas versiones
limit = 8
     →
limit = 12
Coloca el original a la izquierda y la revisión a la derecha, incluida la última línea completa.
Compara líneas, palabras o caracteres, normaliza Unicode y finales de línea de forma explícita y exporta un parche exacto.
Compara líneas, palabras o caracteres, normaliza Unicode y finales de línea de forma explícita y exporta un parche exacto.
limit = 8
→
limit = 12Coloca el original a la izquierda y la revisión a la derecha, incluida la última línea completa.
8  ≠  12

CRLF  ≠  LF
Líneas para estructura, palabras para redacción y caracteres para puntuación. Activa solo las exclusiones pertinentes.
- limit = 8
+ limit = 12
  retry = true
Comprueba eliminaciones y añadidos en paralelo o juntos. El parche descargado describe las entradas exactas.
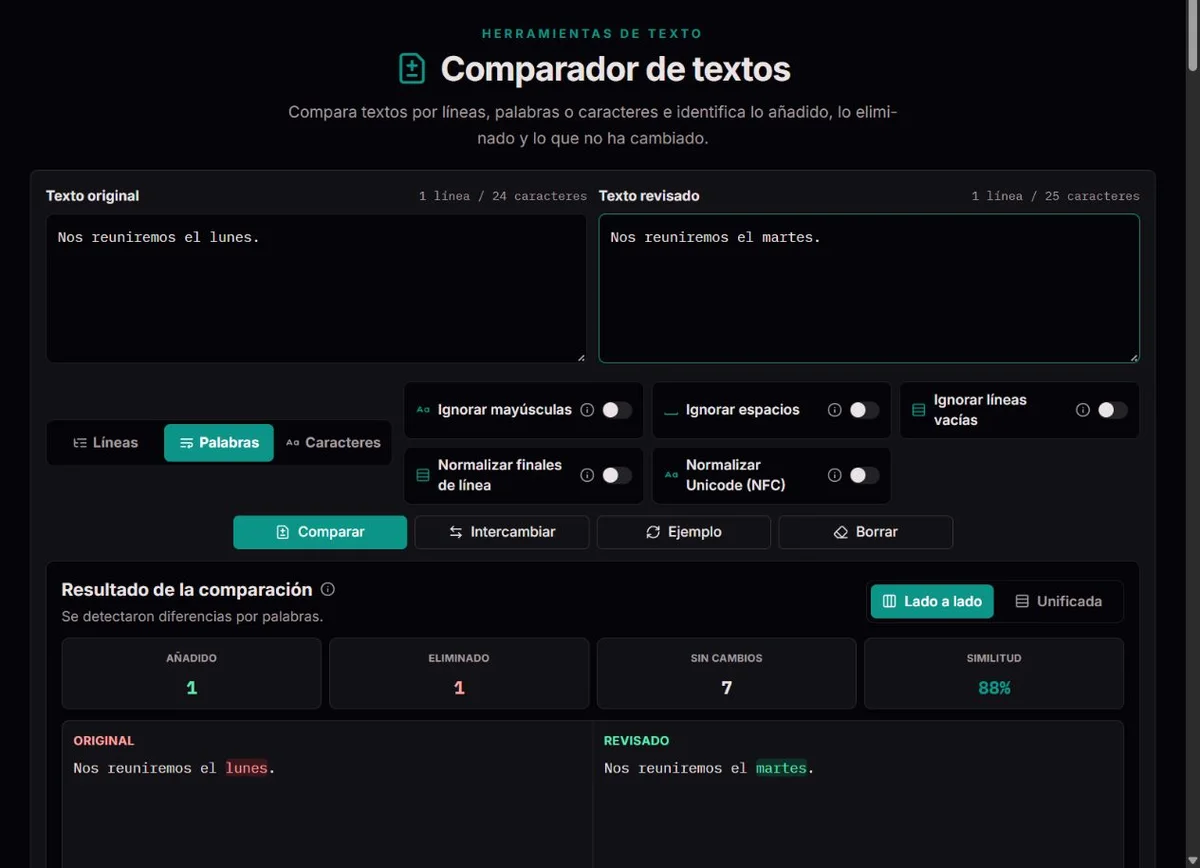
Compare un anuncio y su revisión en Palabras sin reglas de omisión. Lea una fecha cambiada o el paso de puede a hará en contexto y examine puntuación en Caracteres. La vista dividida ayuda a releer cada versión. Un porcentaje alto puede incluir el único cambio decisivo; no equivale a aprobar el texto.
Elija Líneas para un bloque breve y respete espacios donde importe la sangría. Si pasar de sistema cambia cada línea, pruebe aparte normalizar finales. Exporte el parche bruto para revisión y valide la nueva configuración con su analizador o pruebas. No se interpreta YAML, JSON, SQL ni código ejecutable.
Compare etiquetas visualmente iguales exactamente en Caracteres y active solo NFC después. Si desaparece un acento distinto, intervino su representación canónica. Pruebe los finales de línea por separado. Ninguna opción elimina todos los caracteres invisibles o parecidos; reduzca el ejemplo antes de atribuirlo a un fallo visual.
- limit = 8
+ limit = 12
  retry = true
Un diff registra la edición en vez de repetir dos documentos completos. La documentación GNU del formato unificado explica el formato compacto con líneas modificadas y contexto cercano.
El contexto ayuda a localizar el cambio. La descarga usa original.txt y revised.txt y describe líneas incluso si la pantalla compara palabras.
Las líneas repetidas admiten distintas alineaciones. El motor encuentra una secuencia de cambios, no la intención del autor. Revisa el contexto de una frase desplazada.
Una letra acentuada puede ser un punto de código o una letra y una marca combinante. La especificación de normalización de Unicode define la equivalencia canónica. NFC solo cambia la comparación, no los campos.
CRLF y LF son secuencias distintas. La opción correspondiente convierte CRLF y CR aislado en LF para comparar. Ignorar líneas vacías elimina también sus separaciones.
La similitud es dos veces las unidades sin cambios divididas por el total de ambas versiones. Depende del modo y las exclusiones; no mide significado, plagio ni corrección.
Líneas toma una línea completa con su terminación como unidad. Sirve para listas, registros, esquemas, subtítulos y configuraciones, pero cambiar una palabra puede marcar toda la línea. El modo Palabras usa la segmentación del motor de comparación para el texto, la puntuación y los espacios significativos. Según el sistema de escritura y la puntuación, una palabra puede dividirse en fragmentos; las cifras cuentan unidades de comparación, no palabras lingüísticas. Caracteres revela decimales, URL, identificadores y correcciones pequeñas.
Revise primero estructura y luego la edición dudosa. Un párrafo movido puede figurar como eliminación y adición: no se reconoce semánticamente el traslado. Las líneas repetidas admiten alineaciones distintas, por lo que importa el contexto. Se comparan dos cadenas pegadas, sin historial de repositorio, fusión de tres versiones ni comentarios o intención del autor.
Todas las reglas empiezan desactivadas. Examine el resultado exacto y active una por vez. Ignorar mayúsculas convierte a minúsculas, sin cotejo lingüístico. Ignorar líneas vacías elimina las compuestas solo de espacios y une el resto con LF: también puede ocultar terminaciones y límites finales. No es simplemente plegar filas en pantalla.
Ignorar espacios varía por unidad. En Líneas recorta extremos y agrupa espacios o tabulaciones, pudiendo ocultar sangría y terminaciones. En Palabras convierte las secuencias a un espacio. En Caracteres las elimina: a b puede coincidir con ab. No lo active para mejorar el porcentaje; determine si los separadores omitidos afectan al propósito.
| Ejemplo | Ajuste | Efecto |
|---|---|---|
| LF / CRLF | Normalizar finales | CRLF y CR solo pasan a LF al comparar; no cambia los editores. |
é / e + U+0301 | NFC | Equivalencia canónica sin quitar acentos. |
Label / label | Ignorar mayúsculas | Oculta una distinción que puede importar en código o nombres. |
a b / ab | Caracteres + ignorar espacios | Oculta el separador; exactamente son distintos. |
Original a la izquierda, revisión a la derecha: menos/rojo es eliminación, más/verde adición. Neutro significa coincidencia según reglas, no necesariamente igualdad de bytes. Dividida separa versiones; unificada intercala la secuencia. Intercambiar invierte la dirección y cambia adiciones por eliminaciones, sin valorar qué versión es mejor.
Ejemplo reproducible en Líneas sin omisiones: limit = 8 frente a limit = 12, cada una seguida de un salto y retry = true con salto final. Hay una línea eliminada, una añadida y una igual. La similitud es 50 %: 2 × 1 / (2 + 2). Palabras o Caracteres cuentan unidades distintas y producen otro porcentaje para el mismo cambio.
Copiar y descargar diff producen un parche unificado por líneas de las entradas originales, con original.txt y revised.txt. NFC, normalización y reglas no reescriben el archivo. Por ello una pantalla normalizada puede mostrar igualdad y el parche conservar un cambio de representación. Anote los ajustes para explicar la diferencia a otro revisor.
La cabecera identifica archivos antes/después; los bloques indican rangos afectados. Un espacio inicial es contexto, menos una línea antigua y más una nueva. También puede indicarse ausencia de salto final. El parche describe una transformación, no un commit guardado. Confirme destino y versión de partida antes de aplicarlo con otra herramienta; esta página no aplica parches ni resuelve conflictos.
Un error significa cálculo incompleto, no igualdad. Cada entrada admite 50.000 unidades UTF-16; ediciones complejas pueden agotar el presupuesto por debajo de ese límite. La creación del parche tiene su propio límite y también puede faltar. Divida textos largos por secciones con contexto suficiente. No interprete un porcentaje en estado de error como resultado válido.
Compruebe que ambos pegados estén completos, desactive reglas y compare una parte en Caracteres. NFC no equipara comillas rectas y curvas, espacios normales y no separables ni letras latinas y cirílicas parecidas. Las unidades son puntos de código, no emoji o grafemas completos. Para formatos, comentarios, tablas y codificaciones binarias, vuelva al archivo original o use comparación de archivos.
El cálculo local limita cada campo a 50.000 unidades de cadena JavaScript y acota el trabajo de edición. Las líneas pueden reducir espacios, las palabras normalizarlos y los caracteres eliminarlos.
La vista puede ocultar diferencias ignoradas, pero el parche conserva las entradas originales. Los caracteres son puntos de código, no siempre grafemas completos. Cambios grandes pueden alcanzar el límite de cálculo. No se valida sintaxis ni seguridad.
Desactiva exclusiones, verifica las entradas y compara una sección menor. Informa con un ejemplo inventado breve, el modo y las opciones de normalización.
No. Describe las entradas exactas, incluidas las diferencias ocultas en pantalla.
No. Se muestra como texto y se compara literalmente.
Los límites de longitud y trabajo protegen la respuesta. Divide el documento en secciones relevantes.
NFC trata equivalencia canónica, no toda similitud visual. Letras confundibles, caracteres sin ancho, espacios no separables y comillas pueden seguir distintos. Compare exactamente un fragmento y examine puntos de código si hace falta. No borre caracteres invisibles a ciegas en código o identificadores.
Sí: negación, fecha, decimal o permiso puede pesar más que miles de unidades iguales. El porcentaje describe alineación y reglas, no calidad semántica, plagio ni aprobación. Lea cada cambio relevante para el fin del texto.
Se representan adiciones y eliminaciones, no traslados semánticos. Puede desaparecer de una posición y añadirse en otra. Las repeticiones afectan la alineación. Lea párrafos vecinos en vista dividida y revise el orden final; color no significa necesariamente contenido recién escrito.
Las entradas están en memoria de la página, sin restauración tras recargar. Compartir abre la herramienta sin textos. Conserve originales o exportación antes de salir. El parche revela sus cambios, de modo que merece el mismo cuidado que el material revisado.
Sin omisiones, el otro lado es totalmente añadido o eliminado. Dos entradas vacías dan 100 % por convenio, no una revisión válida. Una regla puede borrar el único contenido de espacios. Revise entradas y estado del cálculo antes de interpretar un resultado vacío.