URL-инструменты
Кодирование пробелов в URL: %20 или плюс?
В компоненте URI пробел превращается в %20, а в плюс — только при сериализации в формате формы.
Автор Винешваран Виджаякумар, разработчик и издатель | | Проверено в соответствии с редакционной политикой ClockTools
Оглавление
Пробел в данных URL обычно превращается в %20, но сериализация запроса в формате формы представляет его как +. Оба варианта могут быть верными. Выбор зависит от получателя: отдельный компонент URI кодируйте процентным способом, а плюс используйте только там, где ожидаются данные application/x-www-form-urlencoded.
Кодировщик URL ClockTools явно различает контексты с помощью профилей URI Component, Full URL и Form Data. Вставьте green tea, переключите профили и сравните результаты до изменения кода приложения.
Начните с целевой среды
Не спрашивайте: «Какой символ всегда означает пробел?» Спросите, какой парсер получит значение.
Для сегмента пути, значения фрагмента или значения отдельного запроса надежным представлением является процентное кодирование. Байт UTF-8 символа пробела является шестнадцатеричным. 20, поэтому его тройка с процентным кодированием равна %20.
Для данных HTML-форм соглашение о сериализации использует + для пробела, а буквальный плюс кодирует как %2B. Стандарт URL WHATWG определяет это поведение form-urlencoded отдельно от общего разбора URL.
Синтаксис URI в RFC 3986 определяет процентно-кодированный октет как % и две следующие шестнадцатеричные цифры. Он также различает зарезервированные разделители и незарезервированные символы данных. Поэтому кодирование значения отличается от кодирования целого адреса.
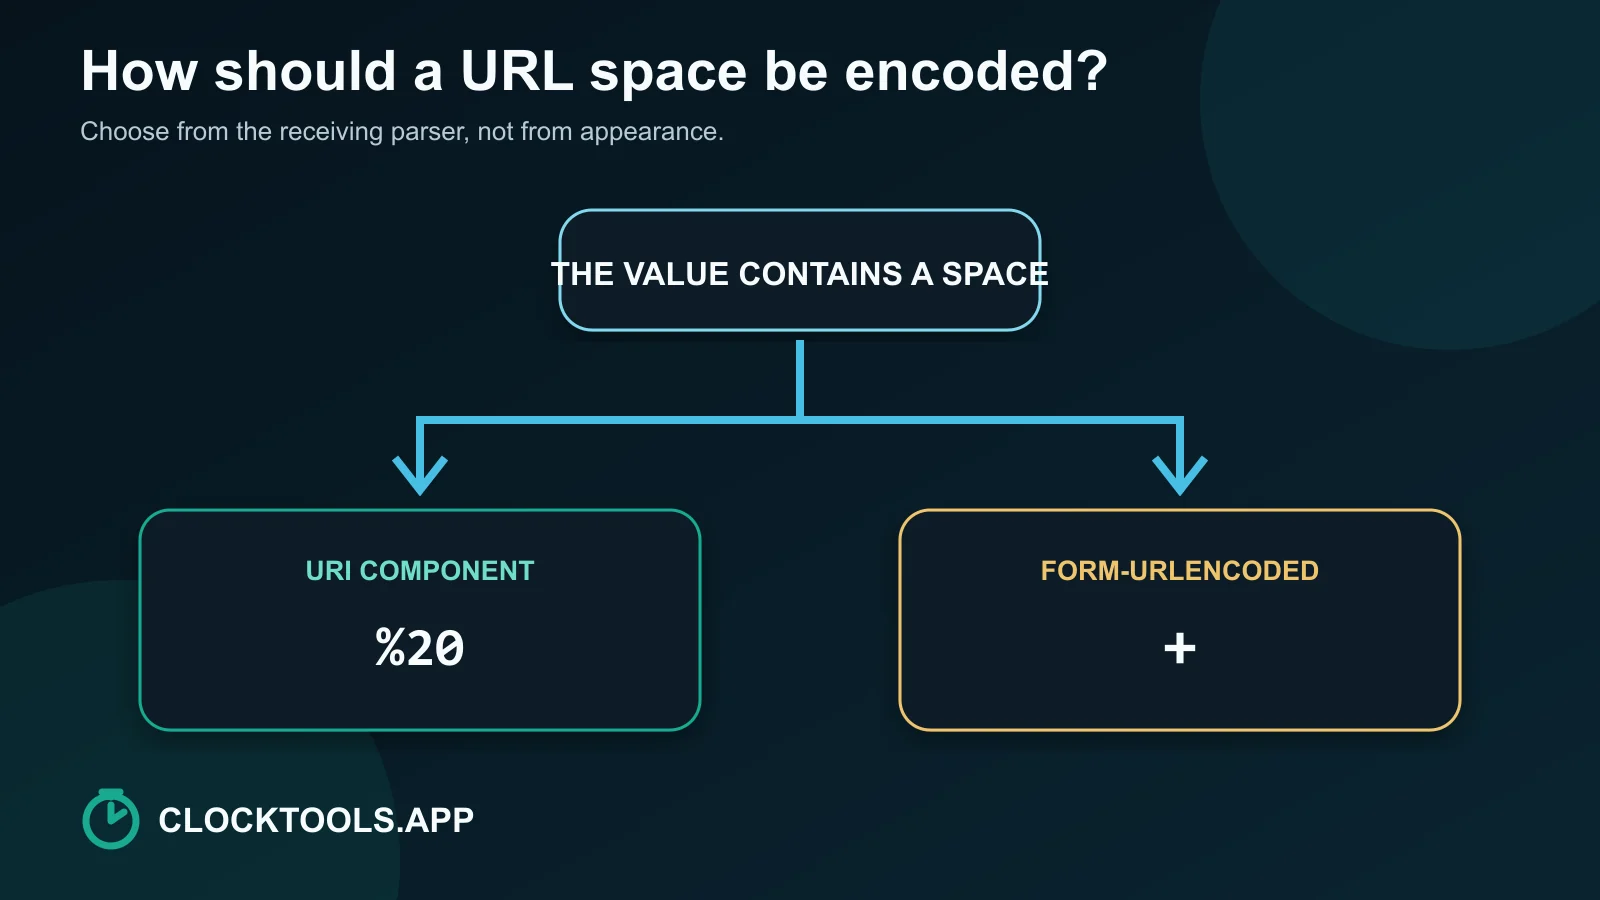
Таблица выбора между %20 и плюсом
| Целевая среда | Представление пробела | Пример для green tea | Почему |
|---|---|---|---|
| Сегмент пути | %20 | /topics/green%20tea | Пробел является данными одного сегмента пути |
| Значение запроса, закодированное как компонент | %20 | ?q=green%20tea | Кодирование компонента отделяет значение от разделителей |
| Запрос или тело запроса в кодировке формы | + | q=green+tea | Сериализатор формы заменяет пробел плюсом |
| Полное отображение URL-адреса | %20 там, где требуется сериализовать буквальный пробел | https://example.com/green%20tea?q=hot%20cup | Структурный :, /, ?, =и & оставаться разделителями |
| Буквальный плюс внутри данных формы | %2B | q=C%2B%2B | В этом профиле незакодированный плюс декодируется как пробел |
Последняя строка предотвращает частую ошибку. Если нужное значение — C++, передача C++ через декодер формы может дать C . Перед разбором формы кодируйте каждый буквальный плюс как %2B.
Четыре воспроизводимых теста ClockTools
Мы выполнили четыре небольших ввода через текущую реализацию инструмента. Его профиль компонента URI использует JavaScript. encodeURIComponent. Данные формы применяют ту же кодировку компонента, а затем заменяют %20 с +. Полный URL-адрес использует encodeURI, который сохраняет структуру URL.
| Ввод | Профиль | Наблюдаемый результат | Интерпретация |
|---|---|---|---|
green tea | URI-компонент | green%20tea | Один компонент с процентно-кодированным пробелом |
green tea | Данные формы | green+tea | Правило пробела для форм |
C++ | Данные формы | C%2B%2B | Буквальные знаки плюс защищены |
https://example.com/a b?q=x y | Полный URL-адрес | https://example.com/a%20b?q=x%20y | Разделители URL-адресов остаются структурными |
Это детерминированные преобразования, а не свидетельство позиций в поиске. Их можно воспроизвести локально в браузере. Страница сразу обновляет результат, показывает процентное экранирование и число байтов; отправлять ввод на сервер не требуется.
Используйте URL-декодер для обратной проверки. Декодируйте green%20tea в профиле компонента, а green+tea — в Form Data. Если плюс появляется вне профиля формы, декодер предупреждает о неоднозначном смысле.
Что защищает кодирование компонентов?
В URL-адресе в качестве грамматики используются пунктуация. В строке запроса & может начать другой параметр и = отделяет имя от значения. # начинается фрагмент. ? начинает запрос. Если один из этих символов принадлежит пользовательским данным, оставление его необработанным может изменить структуру.
Рассмотрим значение timer & alarm. Кодирование компонентов производит timer%20%26%20alarm. Амперсанд становится %26, поэтому парсер получает одно значение вместо интерпретации alarm в качестве нового параметра.
Кодирование — это представление, а не проверка или шифрование. Перенаправление с процентным кодированием все равно может указывать на неутвержденный хост после декодирования. Закодированный сценарий по-прежнему является ненадежным вводом. Проверьте разрешенные схемы, хосты, имена параметров и бизнес-правила после анализа. Избегайте размещения паролей, токенов или других секретных данных в URL-адресах, поскольку адреса могут появляться в истории, журналах, аналитике, снимках экрана и данных реферера.
Когда вам нужно сравнить строку запроса «до» и «после», Проверка текстовых различий делает каждый измененный escape видимым. Это более надежно, чем сканирование длинного URL-адреса обратного вызова на предмет отсутствия одного из них. %25.
Почему двойное кодирование создает %2520?
Двойное кодирование происходит, когда уже закодированный текст обрабатывается как необработанные данные и кодируется снова.
Начните с одного пробела:
space -> %20Кодировать %20 как новый компонент. Знак процента становится %25, а цифры остаются буквальными:
%20 -> %2520Одно декодирование меняется %2520 вернуться к %20. Второе декодирование меняется %20 в пространство. Если ваше приложение ожидает один проход декодирования, но получает значение с двойным кодированием, пользователь может увидеть %20 вместо пустого.
Исправление состоит в том, чтобы не выполнять повторное декодирование, пока текст не станет правильным. Повторное декодирование может изменить намеренно закодированные разделители и создать проблемы безопасности. Определите границу владения: ровно один слой должен кодировать компонент, и ровно один соответствующий слой должен его декодировать.
Порядок отладки несоответствий пробелов
Используйте этот путь, когда одна система отправляет %20 и еще один дисплей +, %2520или буквальный пробел.
- Захватите необработанное значение до того, как какой-либо анализатор платформы изменит его.
- Определите, является ли поле сегментом пути, компонентом запроса, полным URL-адресом или телом формы.
- Запишите ожидаемое декодированное значение, включая буквальные знаки плюс.
- Воспроизведите тот же ввод в соответствующем профиле ClockTools.
- Декодируйте один раз с помощью принимающего профиля.
- Сравните результат с ожидаемым значением.
- Найдите в потоке приложения второй кодер или декодер, если
%25появляется неожиданно.
| Симптом | Первая проверка | Вероятная причина |
|---|---|---|
green+tea остается с плюсом | Профиль декодера | Декодер компонента не заменяет плюс пробелом |
C++ становится C | Кодировка отправителя | Буквальные плюсы не были закодированы как %2B |
%20 виден пользователю | Число декодирований | Закодированные данные никогда не декодировались или ранее подвергались двойному кодированию. |
%2520 появляется в запросе | Число кодирований | Знак процента от %20 был закодирован снова |
| Запрос разбивается после амперсанда | Граница компонента | Амперсанд данных остался необработанным |
Этот путь отладки намеренно узок. Он отделяет контекст данных от догадок, и каждый шаг имеет видимые входные и выходные данные.
Когда следует кодировать полный URL-адрес?
Используйте профиль «Полный URL-адрес» только в том случае, если вы хотите, чтобы адрес оставался адресом. Он сохраняет структурные знаки пунктуации, такие как двоеточие схемы, косая черта, вопросительный знак, знак равенства, амперсанд и маркер фрагмента, при кодировании таких символов, как пробелы.
Используйте URI Component, если полный URL вложен в другой параметр. Например, адрес обратного вызова в redirect= является данными внешнего URL. Кодирование вложенного адреса как одного компонента не дает его ? и & попасть во внешний запрос.
Не прогоняйте адрес через разные профили в надежде получить универсально безопасную строку. Явно задайте границу:
outer URL structure + encodeURIComponent(inner callback URL)Принимающее приложение должно проанализировать внешний URL-адрес, извлечь компонент обратного вызова, один раз декодировать его, проанализировать полученный внутренний URL-адрес и проверить место назначения. Кодирование сохраняет синтаксис нетронутым; проверка решает, разрешен ли пункт назначения.
Часто задаваемые вопросы
Должен ли пробел URL-адреса быть %20 или знаком плюса?
Используйте %20 для пробела внутри общего компонента URI. Используйте +, если принимающий рабочий процесс явно ожидает сериализации application/x-www-form-urlencoded.
Почему знак плюс декодируется как пробел?
Синтаксические анализаторы в стиле формы отображают + в пробел как часть соглашения о кодировке формы. Декодер общего компонента не должен применять эту замену.
Как закодировать буквальный знак плюс в данных формы?
Закодируйте плюс как %2B. Иначе декодер формы может принять незакодированный плюс за пробел.
Что означает %2520?
%2520 обычно указывает на двойное кодирование. Знак процента в существующем escape-коде %20 стал %25, поэтому одно декодирование возвращает %20, а второе декодирование возвращает пробел.
Должен ли я кодировать весь URL-адрес с помощью encodeURIComponent?
Не тогда, когда его схема, косые черты, разделители запроса и маркер фрагмента должны оставаться структурными. Используйте компонентную кодировку, когда весь URL-адрес вложен как данные в другое значение.
Обеспечивает ли кодирование URL-адресов безопасность ненадежного ввода?
Нет. Кодирование сохраняет границы синтаксиса, но получатель все равно должен проверять схемы, хосты, перенаправления, значения параметров, разрешения и другие бизнес-правила после анализа.
Об авторе
Винешваран Виджаякумар
Основатель, разработчик и издатель ClockTools | Менеджер по цифровому маркетингу | Индия
Винешваран — инженер с многолетним техническим опытом, включая работу менеджером по цифровому маркетингу в Дубае. Его работа объединяет анализ данных, поисковую оптимизацию, оптимизацию конверсии, создание контента и визуальных материалов, а также прикладной искусственный интеллект и машинное обучение. В ClockTools он использует этот междисциплинарный опыт для создания специализированных браузерных инструментов и практических руководств с опорой на источники.