Шаг 1
Вставьте обе версии
limit = 8
     →
limit = 12
Поместите оригинал слева, новую версию справа, включая последнюю строку целиком.
Сравнивайте строки, слова или символы, явно нормализуйте Unicode и переводы строк и экспортируйте точный патч.
Сравнивайте строки, слова или символы, явно нормализуйте Unicode и переводы строк и экспортируйте точный патч.
limit = 8
→
limit = 12Поместите оригинал слева, новую версию справа, включая последнюю строку целиком.
8  ≠  12

CRLF  ≠  LF
Строки для структуры, слова для формулировок, символы для пунктуации. Включайте только нужные правила игнорирования.
- limit = 8
+ limit = 12
  retry = true
Просмотрите удаления и добавления рядом или вместе. Скачанный патч описывает точные входные данные.
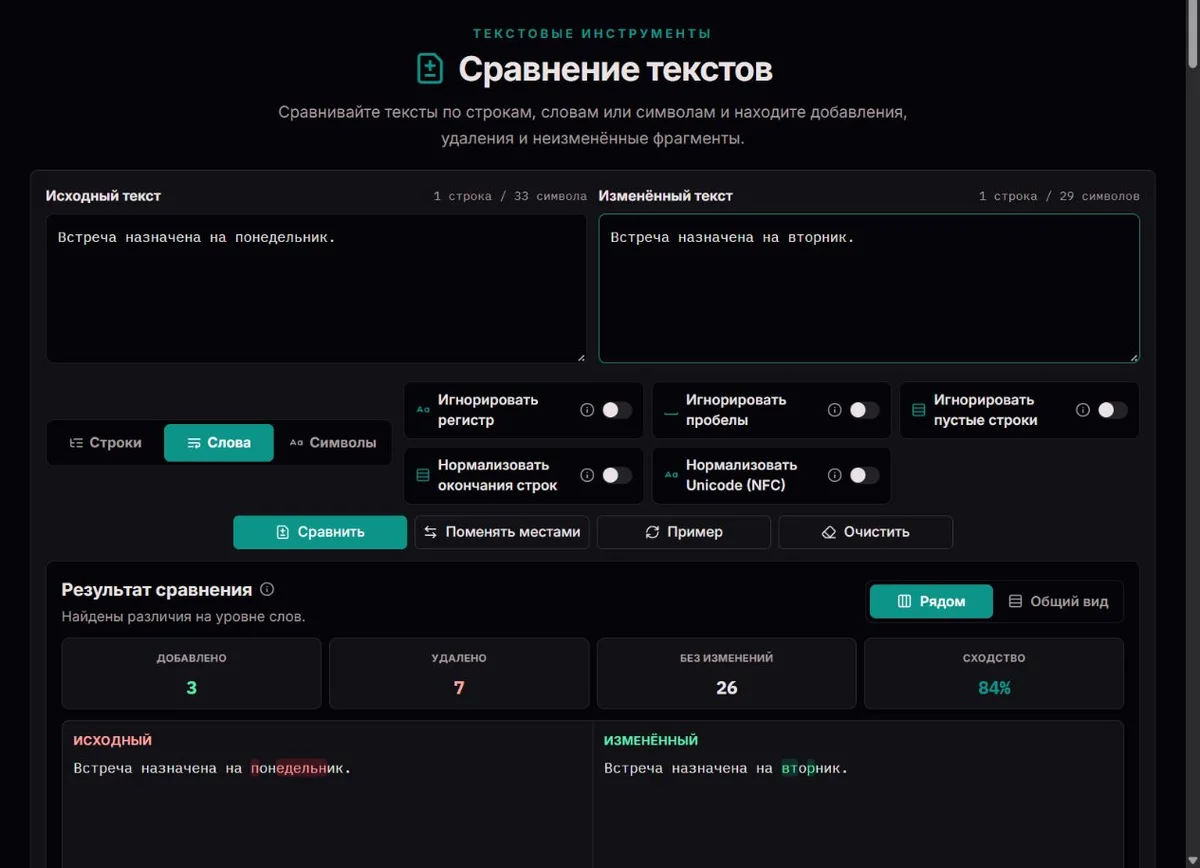
Сравните объявление и правку в режиме слов без игнорирования. Прочтите изменённую дату или переход от может к сделает в контексте, затем проверьте пунктуацию посимвольно. Раздельный вид помогает прочесть версии целиком. Высокий процент может включать единственное решающее изменение и не означает одобрение.
Выберите строки для небольшого блока и учитывайте пробелы, если важны отступы. Если смена системы меняет каждую строку, отдельно попробуйте нормализацию окончаний. Выгрузите исходный патч для проверки и валидируйте новый файл его анализатором или тестами. YAML, JSON, SQL и код здесь не разбираются.
Сравните внешне равные метки точно посимвольно, затем включите только NFC. Если различие акцентов исчезло, дело было в каноническом представлении. Проверяйте окончания строк отдельно. Настройки не убирают все невидимые или похожие знаки; сократите пример перед выводом об ошибке отображения.
- limit = 8
+ limit = 12
  retry = true
Diff записывает правку вместо повторения двух полных документов. Документация GNU об унифицированном формате описывает компактный формат с изменёнными строками и ближайшим контекстом.
Контекст помогает найти правку. Скачанный файл использует original.txt и revised.txt и описывает строки, даже если на экране сравниваются слова.
Повторяющиеся строки допускают разные сопоставления. Алгоритм находит последовательность правок, а не замысел автора. Проверяйте окружение перемещённых предложений.
Буква с акцентом может быть одной кодовой точкой Unicode или буквой с комбинируемым знаком. Стандарт нормализации Unicode определяет каноническую эквивалентность. NFC меняет только сравнение, а не поля ввода.
CRLF и LF — разные последовательности. Нормализация рассматривает CRLF и отдельный CR как LF. Игнорирование пустых строк удаляет и сведения об этих разделителях.
Сходство — удвоенное число неизменённых токенов, делённое на сумму токенов обеих версий. Единица и правила меняют процент. Это не оценка смысла, плагиата или правильности.
Строки считают целую строку с окончанием одним элементом. Это удобно для списков, логов, планов, субтитров и конфигурации, но одно слово может окрасить всю строку. Режим «Слова» использует правила разбиения текста, пунктуации и значимых пробелов, принятые в алгоритме сравнения. В зависимости от письменности и пунктуации одно слово может разбиваться на фрагменты; счётчики отражают элементы сравнения, а не число слов в лингвистическом смысле. Символы помогают проверить десятичную точку, URL, идентификатор или небольшую опечатку.
Сначала смотрите структуру, затем спорную правку. Перемещённый абзац может показаться удалённым и добавленным: семантического распознавания переноса нет. Повторяющиеся строки допускают разные выравнивания, поэтому нужен контекст. Сравниваются две вставленные строки текста, без истории репозитория, трёхстороннего слияния, комментариев или понимания намерений.
Все правила изначально выключены. Сначала посмотрите точный результат и включайте по одному. Игнорирование регистра приводит к строчным буквам, без языкового сопоставления. Игнорирование пустых строк удаляет строки из пробелов и соединяет остальное через LF: могут скрыться окончания и финальная граница. Это не только сворачивание вида.
Пробелы обрабатываются по-разному. В строках убираются краевые пробелы и объединяются пробелы или табуляции, скрывая отступы и иногда окончания. В словах серии превращаются в один пробел. В символах удаляются совсем: a b может совпасть с ab. Не включайте правило ради процента; решите, влияют ли разделители на задачу.
| Пример | Настройка | Результат |
|---|---|---|
| LF / CRLF | Нормализация окончаний | CRLF и одиночный CR становятся LF для сравнения; поля не меняются. |
é / e + U+0301 | NFC | Каноническая эквивалентность без удаления акцентов. |
Label / label | Игнорировать регистр | Скрывает различие, важное для кода или имён. |
a b / ab | Символы + игнорировать пробелы | Скрывает разделитель, но исходники различны. |
Исходник слева, правка справа: минус/красный — удаление, плюс/зелёный — добавление. Нейтральное совпало по правилам, не обязательно побайтно. Раздельный вид оставляет стороны, единый чередует изменения. Поменять местами обращает направление и добавления/удаления, не оценивая, какая версия лучше.
Проверяемый пример в строках без правил: limit = 8 меняется на limit = 12, далее в обеих версиях перенос и retry = true с завершающим переносом. Одна строка удалена, одна добавлена, одна совпала. Сходство 50 %: 2 × 1 / (2 + 2). Слова и символы считают другие элементы и дают иной процент той же правки.
Копирование и скачивание diff дают единый построчный патч исходных вводов с именами original.txt и revised.txt. NFC, нормализация и правила не переписывают выгрузку. Нормализованный экран может показывать равенство, а патч — изменение представления. Запишите настройки для другого проверяющего.
Заголовок называет файлы до/после; блоки задают диапазоны строк. Начальный пробел — контекст, минус — старая строка, плюс — новая. Может отмечаться отсутствие последнего переноса. Патч — инструкция изменения, не сохранённый коммит. До применения проверьте цель и базовую версию в другом инструменте; эта страница патчи не применяет и конфликты не разрешает.
Ошибка означает расчёт не завершён, не равенство. Каждый ввод ограничен 50 000 единицами UTF-16; сложные изменения могут исчерпать бюджет раньше. Патч рассчитывается отдельно с ограничением и тоже может отсутствовать. Делите большие тексты на смысловые части с контекстом. Процент при ошибке не является действительным результатом.
Проверьте полноту обоих вводов, выключите правила и сравните фрагмент посимвольно. NFC не приравнивает прямые и фигурные кавычки, обычный и неразрывный пробел, похожие латинские и кириллические буквы. Элементы — кодовые точки, не цельные эмодзи или графемы. Для оформления, комментариев, таблиц и двоичных кодировок нужен оригинальный документ или сравнение файлов.
Локальный расчёт ограничивает каждое поле 50 000 единицами строк JavaScript и ограничивает работу алгоритма. В строках можно объединять пробелы, в словах нормализовать пробельные символы, а в посимвольном режиме удалять их.
Экран может скрывать игнорируемые различия, но патч сохраняет исходный ввод. Здесь символы считаются по кодовым точкам Unicode, не всегда совпадающим с целыми видимыми графемами. Большие изменения могут достичь предела расчёта. Синтаксис и безопасность не проверяются.
Отключите игнорирование, проверьте ввод и сравните меньший фрагмент. Для отчёта используйте короткий вымышленный пример, режим и настройки нормализации.
Нет. Он описывает точный ввод, включая скрытые на экране различия.
Нет. Содержимое отображается как текст и сравнивается буквально.
Ограничения длины и работы сохраняют отзывчивость. Разделите документы на нужные фрагменты.
NFC обрабатывает каноническую эквивалентность, не всякое визуальное сходство. Похожие буквы, нулевая ширина, неразрывные пробелы и кавычки могут отличаться. Сравните короткий фрагмент точно и при необходимости проверьте кодовые точки. Не удаляйте невидимые знаки вслепую из кода или идентификаторов.
Да: отрицание, дата, десятичный знак или разрешение могут значить больше тысяч совпавших элементов. Процент описывает выравнивание и правила, не смысловое качество, плагиат или одобрение. Прочтите каждую правку, влияющую на назначение текста.
Показываются добавления и удаления, не семантические перемещения. Абзац исчезает здесь и появляется там. Повторы влияют на выравнивание. Проверьте соседей в раздельном виде и финальный порядок; цвет не обязательно означает новый авторский текст.
Вводы остаются в памяти страницы, без восстановления после перезагрузки. Поделиться открывает инструмент без текста. Сохраните оригиналы или выгрузку перед выходом. Патч раскрывает изменения и требует той же осторожности, что материал проверки.
Без правил другой текст полностью добавлен или удалён. Два пустых ввода дают 100 % по соглашению, не доказывают проверку документа. Правило может удалить весь пробельный текст. Проверьте вводы и состояние расчёта перед выводами.