Etapa 1
Escolha o modo correspondente
Componente decodifica separadores; URI inteira preserva seus escapes; formulário converte + em espaço.
Uma passagem remove uma camada e mantém o original editável.
Uma passagem remove uma camada e mantém o original editável.
Componente decodifica separadores; URI inteira preserva seus escapes; formulário converte + em espaço.
Escapes incompletos ou UTF-8 inválido geram erro sem alterar a entrada.
Copie ou baixe o resultado. Investigue os escapes restantes sem repetir automaticamente a decodificação.
Num registro, identifique primeiro campos codificados. Em q=A%26B&lang=en, q vale A%26B; componente produz A&B. Decodificar tudo antes faria o símbolo interno parecer outro separador.
Guarde o original e compartilhe amostras fictícias. O texto pode revelar nomes ou tokens. A página inspeciona um valor, não uma coleção de campos ou destino de redirecionamento.
Compare C++ com C%2B%2B. Componente dá C++ nos dois; formulário transforma sinais + literais em espaços, mas %2B em sinais +.
Determine a convenção do emissor antes de mudar. Espaço inesperado não prova espaço original. O aviso de + pede investigação, não mudança automática para formulário.
Num valor aninhado, decodifique %252F uma vez para %2F e determine a camada. Uma segunda passagem componente separada produziria /.
Pode ser certo para valor interno e errado para endereço inteiro. Guarde cada etapa, não continue até legibilidade. Ler não valida assinatura, destino ou caminho pretendido.
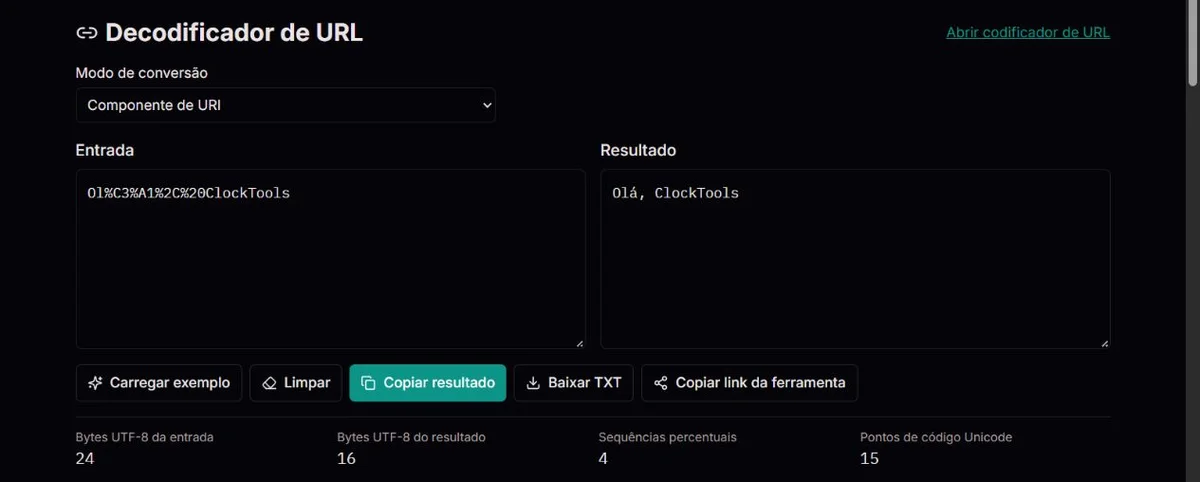
Componente decodifica escapes reservados do valor. URI inteira preserva os que decodeURI trata como estrutura. Formulário substitui + literais por espaços primeiro e depois decodifica estritamente. Escolha a convenção do emissor, não a saída mais familiar.
É processada uma cadeia, não uma coleção analisada. Para vários campos identifique separadores codificados antes de decodificar nomes e valores. Um %26 interno não deve virar separador por decodificação prematura da coleção.
JavaScript define o conjunto preservado de decodeURI, incluindo os sinais /, & e +. %2F%26 permanece em URI inteira enquanto componente dá /&. Preservar sequências pode ser saída correta, não falha. ECMAScript decodeURI e conjunto de escapes preservados.
%252FEntrada aninhada%2FApós uma passagem/Após outra passagem separada%252F vira %2F, não /. Pode ser um valor aninhado de propósito ou uma codificação dupla por engano. Diferencie as causas antes de corrigir.
Decodificar até nada mudar pode transformar dados em estrutura. Uma barra muda segmentos e & separa campos. Preserve o original e identifique as camadas esperadas.
decodeURI mantém %2F e %26; decodeURIComponent os recupera dentro de um valor. A norma explica por que não se deve apagar esses limites indiscriminadamente. Orientação de decodificação do RFC 3986.
Dois dígitos após % não bastam. %C3%A9 representa é, mas %C3%28 não é UTF-8 válido. Nenhum símbolo de substituição é inserido para esconder o problema.
Dados antigos podem usar outra codificação. Esta ferramenta não detecta conjuntos de caracteres nem interpreta Latin-1. Obtenha a codificação original.
No formulário, + é substituído antes da decodificação, por isso %2B continua sendo um sinal de mais. Diferentemente do analisador tolerante WHATWG, bytes UTF-8 inválidos são rejeitados aqui. Ordem de análise de formulários WHATWG.
A tabela compara a mesma entrada semelhante a formulário. %2B vira um sinal + em componente/formulário; só um + literal vira espaço em formulário. A ordem preserva a diferença. URI inteira mantém %2B, pois o sinal + pertence ao conjunto preservado.
O contador de escapes descreve entrada. Bytes e pontos de código de saída descrevem texto decodificado, não glifos. caf%C3%A9 dá café: dois escapes representam os dois bytes de é; saída tem cinco bytes UTF-8 e quatro pontos. Saída vazia com erro não é valor vazio bem convertido.
O exemplo substitui entrada; Limpar remove. Copiar e TXT usam resultado e ficam desativados sem saída. O link compartilha página apenas e o do codificador não transfere texto. Guarde original e modo para comparar ida e volta.
| Entrada | Modo | Resultado |
|---|---|---|
| caf%C3%A9 | Componente URI | café |
| A%2BB+C | Valor de formulário | A+B C |
| A%2BB+C | Componente URI | A+B+C |
| %2F%26 | URI inteira | %2F%26 |
| %252F | Componente URI | %2F |
| %C3%28 | Componente URI | Erro UTF-8; sem saída |
A linha de erro não é texto parcial. Nenhum exemplo visita ou certifica endereço.
Um %, %2 ou %GG final falha na sintaxe. Um sinal de porcentagem literal precisa de %25; substituir todos ocultaria escapes válidos. Confira fonte ou emissor, não adivinhe correção de cadeia incompleta.
%E9 tem sintaxe correta, mas sozinho não representa é em UTF-8; %C3%A9 representa. %C3%28 e %FF também são rejeitados mesmo com dois dígitos por escape. O erro estrito evidencia problema de bytes. Não é decodificador Latin-1 ou detector de charset.
Se resta %2F, distinga preservação de URI inteira e sinal de porcentagem externo codificado. Confira modo e original antes de outra passagem. Um % solto em texto misto pode falhar toda conversão; entrada fica editável e não há saída parcial.
Se falharem cópia ou exportação, use resultado visível e outra ação disponível. Não envie redirecionamentos privados ou credenciais em relatos. Decodificar não verifica host, assinatura, acesso ou confiança, e a página nunca abre o endereço.
Escapes são verificados antes de uma passagem estrita do JavaScript. Formulário normaliza primeiro os sinais de mais. Erros não geram resultado parcial nem substituem a entrada.
O resultado não comprova segurança nem acessibilidade. Não há abertura de links, validação de assinaturas, formulários completos ou codificações diferentes de UTF-8.
Corrija a sequência original ou solicite UTF-8 válido. Relate modo e exemplo fictício, sem redirecionamentos privados. Teste a correção com o receptor.
O modo preserva delimitadores reservados; use componente para um valor.
Só formulário interpreta um sinal de mais literal como espaço.
Não. Cada passagem remove uma camada.
E9 sozinho não é UTF-8 válido para é; usa-se C3 A9. Outro pode supor charset antigo ou substituir bytes. Descubra a codificação original em vez de tomar uma letra legível por prova. Aqui só há UTF-8 estrito.
Sintaxe e UTF-8 são verificações diferentes. C3 começa uma sequência multibyte; 28 não é continuação válida. Há erro sem saída parcial e original editável para investigar byte ausente ou alterado.
Não. %26 vira & e pode parecer separador. Identifique fronteiras codificadas primeiro e decodifique cada valor pela convenção. A ferramenta não faz análise estruturada nem monta consulta corrigida.
Confira estado. Entrada vazia dá vazio; sintaxe ou UTF-8 errados também, mas com erro. Original segue corrigível e cópia/exportação ficam desativadas. Erro não significa limpeza de caracteres indesejados.
É decodificador percentual, não seletor geral de formatos. & e Base64 não são interpretados como tais. Obtenha o formato real e use ferramenta correspondente; permanecer igual não prova codificação percentual.