Etapa 1
Colar as duas versões
limit = 8
     →
limit = 12
Coloque o original à esquerda e a revisão à direita, incluindo a última linha completa.
Compare linhas, palavras ou caracteres, normalize Unicode e finais de linha de forma explícita e exporte um patch exato.
Compare linhas, palavras ou caracteres, normalize Unicode e finais de linha de forma explícita e exporte um patch exato.
limit = 8
→
limit = 12Coloque o original à esquerda e a revisão à direita, incluindo a última linha completa.
8  ≠  12

CRLF  ≠  LF
Linhas para estrutura, palavras para redação e caracteres para pontuação. Ative somente as regras adequadas à revisão.
- limit = 8
+ limit = 12
  retry = true
Confira remoções e adições lado a lado ou juntas. O patch baixado descreve as entradas exatas.
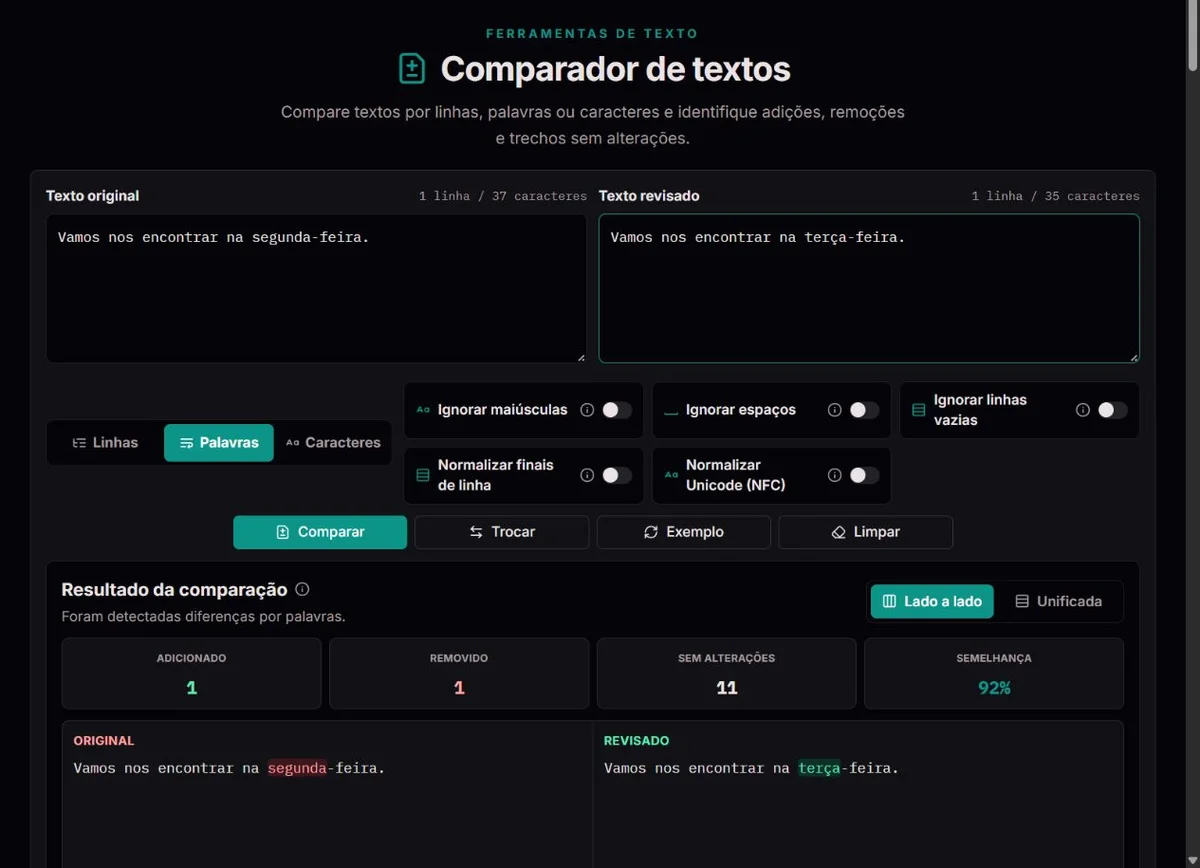
Compare comunicado e revisão em Palavras, sem ignorar diferenças. Leia uma data alterada ou uma troca de pode por fará no contexto; depois confira pontuação em Caracteres. A vista dividida ajuda a reler cada versão. Similaridade alta pode incluir a única alteração decisiva; não aprova o texto.
Escolha Linhas para um bloco pequeno e preserve espaços quando o recuo importar. Se uma mudança de sistema alterar todas as linhas, teste separadamente normalizar finais. Exporte o patch bruto para revisão e valide a versão nova com o analisador ou os testes adequados. YAML, JSON, SQL e código não são interpretados aqui.
Compare rótulos visualmente iguais de modo exato em Caracteres, depois ative somente NFC. Se a diferença de acento sumir, havia uma representação canônica distinta. Teste finais de linha separadamente. Nenhuma opção elimina todos os caracteres invisíveis ou parecidos; reduza o exemplo antes de concluir que a tela está errada.
- limit = 8
+ limit = 12
  retry = true
Um diff registra uma edição em vez de repetir documentos inteiros. A documentação GNU do formato unificado explica o formato compacto com linhas alteradas e contexto próximo.
O contexto ajuda a localizar a edição. O download usa original.txt e revised.txt e descreve linhas mesmo quando a tela compara palavras.
Linhas repetidas admitem mais de um alinhamento. O mecanismo encontra uma sequência de edições, não a intenção do autor. Confira o contexto de uma frase deslocada.
Uma letra acentuada pode ser um ponto de código ou uma letra seguida de marca combinante. A especificação de normalização do Unicode define equivalência canônica. NFC afeta só a comparação, não os campos.
CRLF e LF são diferentes. A opção de normalização trata CRLF e CR isolado como LF. Ignorar linhas vazias remove também suas informações de separação.
A similaridade é duas vezes as unidades inalteradas divididas pelo total das duas versões. Modo e regras mudam a porcentagem. Não é uma medida de significado, plágio ou correção.
Linhas trata a linha completa, incluindo terminação, como unidade. Serve para listas, logs, roteiros, legendas e configurações, mas uma palavra alterada pode marcar a linha inteira. O modo Palavras usa a segmentação do motor de comparação para texto, pontuação e espaços significativos. Conforme o sistema de escrita e a pontuação, uma palavra pode ser dividida em fragmentos; as contagens representam unidades de comparação, não palavras no sentido linguístico. Caracteres ajuda com decimais, URLs, identificadores e correções pequenas.
Examine estrutura antes de detalhar a alteração incerta. Um parágrafo movido pode aparecer como exclusão e inclusão, sem reconhecimento semântico de movimento. Linhas repetidas permitem alinhamentos distintos; releia o contexto. São comparadas duas sequências coladas, sem histórico de repositório, merge de três versões, comentários ou intenção do autor.
Todas as regras começam desligadas. Veja primeiro o resultado exato e ative uma por vez. Ignorar caixa converte para minúsculas, sem comparação linguística. Ignorar linhas vazias remove linhas só de espaços e junta o restante com LF; pode ocultar também diferenças de terminação e limite final. Não é apenas recolher linhas visualmente.
Ignorar espaços depende da unidade. Em Linhas remove margens e agrupa espaços ou tabulações, podendo ocultar recuos e terminações. Em Palavras reduz sequências a um espaço. Em Caracteres remove todas: a b pode coincidir com ab. Não ative só para aumentar a porcentagem; decida se os separadores dispensados importam.
| Exemplo | Ajuste | Efeito |
|---|---|---|
| LF / CRLF | Normalizar finais | CRLF e CR isolado viram LF para comparar; editores intactos. |
é / e + U+0301 | NFC | Equivalência canônica sem remover acentos. |
Label / label | Ignorar caixa | Oculta maiúsculas que podem importar em código ou nomes. |
a b / ab | Caracteres + ignorar espaços | Oculta separador; os originais continuam distintos. |
Original à esquerda, revisão à direita: menos/vermelho significa remoção, mais/verde adição. Neutro corresponde pelas regras, não necessariamente byte a byte. Dividida separa versões; unificada intercala a sequência. Trocar inverte a direção e transforma adições em remoções, sem avaliar qual versão é melhor.
Exemplo verificável em Linhas, sem exclusões: limit = 8 vira limit = 12, ambas seguidas de quebra e retry = true com quebra final. Uma linha removida, uma adicionada e uma igual. Similaridade de 50 %: 2 × 1 / (2 + 2). Palavras e Caracteres usam unidades diferentes e produzem outro valor para a mesma edição.
Copiar e baixar diff geram um patch unificado por linhas das entradas brutas, com nomes original.txt e revised.txt. NFC, normalização e regras não reescrevem esse arquivo. Uma tela normalizada pode parecer igual enquanto o patch registra diferença de representação. Guarde os ajustes para explicar a distinção a outro revisor.
Cabeçalho identifica antes/depois; cabeçalhos de bloco apontam intervalos de linhas. Espaço inicial significa contexto, menos linha antiga e mais nova. Pode ser registrada a falta de quebra final. Patch é uma instrução de transformação, não um commit salvo. Confira destino e base na ferramenta que o aplicará; esta página não aplica patches nem resolve conflitos.
Erro significa cálculo incompleto, não igualdade. Cada entrada aceita 50.000 unidades UTF-16, mas mudanças complexas podem estourar o orçamento antes. O patch tem cálculo limitado próprio e também pode faltar. Divida textos grandes por seções com contexto suficiente. Porcentagem num estado de erro não é resultado válido.
Confira os dois textos completos, desligue regras e compare um trecho em Caracteres. NFC não iguala aspas retas e curvas, espaços comuns e inseparáveis, letras latinas e cirílicas parecidas. Unidades são pontos de código, não emoji ou grafemas inteiros. Para formatação, comentários, tabelas ou codificações binárias, volte ao documento ou use comparação de arquivos.
O cálculo local limita cada campo a 50.000 unidades de string JavaScript e restringe o trabalho de edição. Linhas podem reduzir espaços, palavras normalizá-los e caracteres removê-los.
A tela pode esconder diferenças ignoradas, mas o patch mantém as entradas brutas. Caracteres são pontos de código, não necessariamente grafemas completos. Mudanças grandes podem atingir o limite de cálculo. Sintaxe e segurança não são validadas.
Desative regras, confira as entradas e compare uma seção menor. Relate problemas com um exemplo fictício curto, modo e opções de normalização.
Não. Ele descreve as entradas exatas, inclusive diferenças ocultas na tela.
Não. O conteúdo é exibido como texto e comparado literalmente.
Limites de tamanho e trabalho protegem a resposta. Divida os documentos em partes relevantes.
NFC trata equivalência canônica, não toda semelhança visual. Letras confundíveis, caracteres sem largura, espaços inseparáveis e aspas podem continuar distintos. Compare um pequeno trecho exatamente e examine pontos de código se preciso. Não apague caracteres invisíveis às cegas em código ou identificadores.
Sim: negação, data, decimal ou permissão pode importar mais que milhares de unidades iguais. O valor descreve alinhamento e regras, não qualidade semântica, plágio ou aprovação. Leia cada alteração relevante para a finalidade do texto.
O resultado representa inclusões e exclusões, não movimentos semânticos. O parágrafo pode ser removido aqui e adicionado ali. Repetições afetam o alinhamento. Examine vizinhos na vista dividida e a ordem final; cor não significa necessariamente texto recém-escrito.
Entradas ficam na memória da página, sem restauração após recarregar. Compartilhar abre a ferramenta sem os textos. Preserve originais ou exportação antes de sair. O patch revela mudanças e merece o mesmo cuidado que o conteúdo comparado.
Sem regras, o conteúdo do outro lado é todo adicionado ou removido. Duas entradas vazias dão 100 % por convenção, não comprovam revisão. Uma regra pode retirar o único conteúdo de espaços. Confira entradas e estado de cálculo antes de interpretar um resultado vazio.