Schritt 1
Beide Fassungen einfügen
limit = 8
     →
limit = 12
Den ursprünglichen Text links, die Überarbeitung rechts einfügen. Auch die letzte Zeile vollständig übernehmen.
Texte nach Zeilen, Wörtern oder Zeichen vergleichen, Zeilenenden und Unicode gezielt normalisieren und einen exakten Patch exportieren.
Texte nach Zeilen, Wörtern oder Zeichen vergleichen, Zeilenenden und Unicode gezielt normalisieren und einen exakten Patch exportieren.
limit = 8
→
limit = 12Den ursprünglichen Text links, die Überarbeitung rechts einfügen. Auch die letzte Zeile vollständig übernehmen.
8  ≠  12

CRLF  ≠  LF
Zeilen für Struktur, Wörter für Formulierungen oder Zeichen für Satzzeichen wählen. Nur passende Ignorierregeln aktivieren.
- limit = 8
+ limit = 12
  retry = true
Entfernungen und Ergänzungen nebeneinander oder gemeinsam prüfen. Der Patch beschreibt die unveränderten Eingaben.
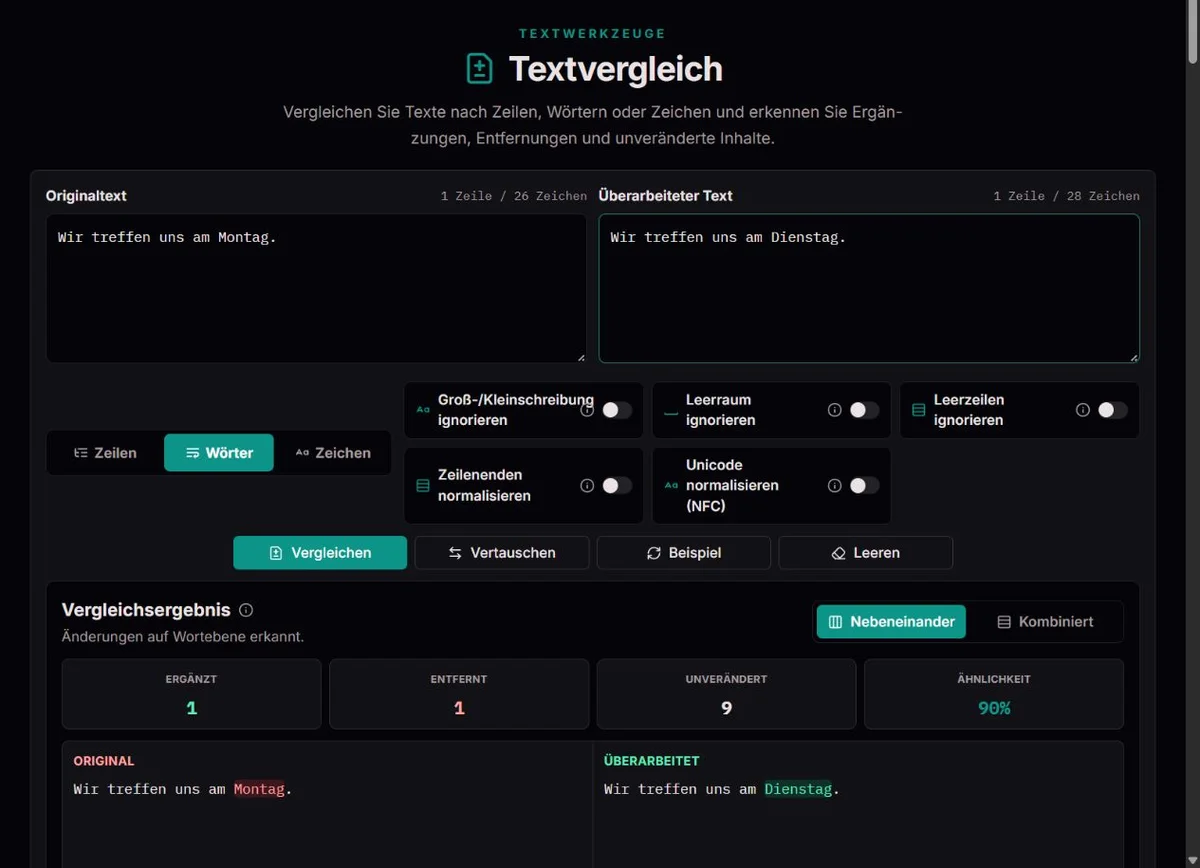
Vergleichen Sie eine Mitteilung und ihre Überarbeitung im Wortmodus zunächst ohne Ignorierregeln. Lesen Sie ein verändertes Datum oder einen Wechsel von kann zu wird im Satzkontext; prüfen Sie Satzzeichen anschließend zeichenweise. Die geteilte Ansicht erleichtert das Lesen beider Fassungen. Hohe Ähnlichkeit kann gerade die entscheidende Änderung enthalten und ersetzt keine Freigabeprüfung.
Nutzen Sie Zeilen für einen kleinen Konfigurationsblock und beachten Sie Leerraum, wenn Einrückungen oder Trennzeichen relevant sind. Ändert ein Systemwechsel scheinbar jede Zeile, testen Sie separat die Zeilenendennormalisierung. Exportieren Sie den unveränderten Patch als Prüfbeleg und validieren Sie die neue Datei mit ihrem Parser oder Tests. YAML, JSON, SQL oder Programmcode werden hier nicht verstanden.
Vergleichen Sie gleich aussehende kurze Bezeichnungen zunächst exakt im Zeichenmodus, danach nur mit NFC. Verschwindet die Akzentabweichung, war die kanonische Darstellung beteiligt. Prüfen Sie bei mehrzeiligem Text die Zeilenenden getrennt. Keine Option entfernt sämtliche unsichtbaren oder verwechselbaren Zeichen. Grenzen Sie das Beispiel ein, bevor Sie einen Anzeigefehler vermuten.
- limit = 8
+ limit = 12
  retry = true
Ein Diff hält Änderungen fest, statt zwei Dokumente vollständig zu wiederholen. Die GNU-Dokumentation zum Unified-Format erläutert das kompakte Format mit geändertem Text und benachbarten Kontextzeilen.
Der Kontext hilft beim Einordnen. Der Download verwendet original.txt und revised.txt und beschreibt Zeilenänderungen, auch wenn die Anzeige Wörter vergleicht.
Wiederholte Zeilen können unterschiedlich zugeordnet werden. Das Verfahren findet eine Änderungsfolge, versteht aber keine Absicht. Verschobene Sätze im Zusammenhang prüfen.
Ein Akzent kann Teil eines Zeichens oder ein zusätzliches kombinierendes Zeichen sein. Der Unicode-Standard zur Normalisierung definiert kanonische Normalisierung. NFC verändert nur den Vergleich, nicht die Eingabefelder.
CRLF und LF sind verschieden. Die optionale Normalisierung behandelt CRLF und einzelne CR als LF. Das Ignorieren leerer Zeilen entfernt auch deren Trenninformationen.
Ähnlichkeit ist zweimal die Zahl unveränderter Tokens geteilt durch beide Tokenzahlen. Einheit und Ignorierregeln verändern den Wert. Er misst weder Bedeutung noch Plagiate oder Richtigkeit.
Zeilenmodus betrachtet jede vollständige Zeile mitsamt Ende als Token. Das eignet sich für Listen, Logauszüge, Gliederungen, Untertitel und Einstellungen; ein einziges ersetztes Wort kann jedoch die ganze Zeile markieren. Der Wortmodus verwendet die Tokenisierung der Vergleichslogik für Text, Satzzeichen und gegebenenfalls relevante Leerraumfolgen. Je nach Schriftsystem und Zeichensetzung kann ein Wort in Fragmente zerfallen; die Zahlen zählen Vergleichseinheiten, keine sprachlichen Wörter. Zeichenmodus zeigt Änderungen an Dezimalpunkten, URLs, Kennungen oder kurzen Schreibweisen.
Prüfen Sie zuerst die Struktur und danach die fragliche Einzelstelle. Ein verschobener Absatz kann als Löschung plus Ergänzung erscheinen; eine Verschiebung wird nicht semantisch erkannt. Wiederholte Zeilen erlauben unterschiedliche Zuordnungen, weshalb Kontext wichtig bleibt. Das Werkzeug vergleicht zwei eingefügte Zeichenfolgen, keine Repository-Historie, Dreiwegezusammenführung oder Kommentare.
Alle Ignorier- und Normalisierungsoptionen sind zunächst aus. Sehen Sie sich erst das exakte Ergebnis an. Großschreibung ignorieren nutzt Kleinschreibung, keine sprachabhängige Sortierung oder Kennungsprüfung. Leerzeilen ignorieren entfernt nur aus Leerraum bestehende Zeilen und verbindet den Rest mit LF. Dadurch können auch Unterschiede an Zeilenenden und am Textende verschwinden; es ist keine reine Ansichtsverkürzung.
Leerraum ignorieren wirkt je nach Einheit anders. Bei Zeilen werden Randabstände entfernt und Leerzeichen beziehungsweise Tabulatoren zusammengefasst; auch eine reine Endungsabweichung kann verschwinden. Bei Wörtern werden Leerraumfolgen zu einzelnen Leerzeichen. Bei Zeichen wird Leerraum ganz entfernt: a b kann dann ab entsprechen. Aktivieren Sie das nicht zur Verschönerung des Prozentsatzes, sondern nur, wenn die ausgelassenen Unterschiede bedeutungslos sind.
| Beispiel | Option | Wirkung |
|---|---|---|
| LF gegenüber CRLF | Zeilenenden normalisieren | CRLF und einzelnes CR werden für den Vergleich LF; Eingaben bleiben gleich. |
é gegenüber e + U+0301 | NFC | Kanonisch gleichwertige Akzente können übereinstimmen; Akzente bleiben erhalten. |
Label gegenüber label | Großschreibung ignorieren | Verbirgt Großschreibung, die bei Code oder Namen relevant sein kann. |
a b gegenüber ab | Zeichen + Leerraum ignorieren | Entfernt den Trenner; exakt bleiben die Texte verschieden. |
Links steht das Original, rechts die Überarbeitung. Minus/Rot bedeutet entfernt, Plus/Grün hinzugefügt. Neutral heißt gleich unter den gewählten Regeln, nicht zwingend bytegleich. Geteilte Ansicht hält die Fassungen getrennt, vereinheitlichte Ansicht zeigt die Änderungsfolge kompakt. Vertauschen kehrt die Richtung um: Ergänzungen werden Löschungen. Das bewertet keine Fassung als besser.
Ein nachprüfbares Zeilenbeispiel ohne Ignorierregeln: links limit = 8, rechts limit = 12, jeweils gefolgt von einem Umbruch und der identischen Zeile retry = true samt Umbruch. Eine Zeile wurde entfernt, eine ergänzt, eine blieb gleich. Ähnlichkeit: 50 %, also 2 × 1 / (2 + 2). Im Wort- oder Zeichenmodus ändern sich Token und Prozentsatz, obwohl die Bearbeitung dieselbe ist.
Diff kopieren und herunterladen liefern einen vereinheitlichten, zeilenweisen Patch aus den Rohtexten. Die Dateinamen lauten original.txt und revised.txt. Ignorierregeln, NFC und Zeilenendennormalisierung verändern den Export nicht. Ein normalisierter Bildschirm kann deshalb keine Abweichung zeigen, während der Patch eine Darstellungsänderung enthält. Notieren Sie die Vergleichseinstellungen für andere Prüfer.
Der Dateikopf benennt Vorher und Nachher; der Blockkopf bezeichnet betroffene Zeilenbereiche. Im Block kennzeichnet ein führendes Leerzeichen Kontext, Minus eine alte und Plus eine neue Zeile. Auch ein fehlender abschließender Umbruch kann dokumentiert werden. Ein Patch ist eine Änderungsanweisung, kein Repository-Commit. Prüfen Sie Ziel und Ausgangsstand im Zielwerkzeug; diese Seite wendet nichts an und löst keine Konflikte.
Ein Vergleichsfehler bedeutet nicht abgeschlossen, nicht identisch. Pro Eingabe sind 50.000 UTF-16-Codeeinheiten erlaubt; aufwendige Änderungen können schon darunter das Rechenbudget überschreiten. Der Patch wird separat begrenzt berechnet und kann ebenfalls fehlen. Teilen Sie große Texte an sinnvollen Abschnittsgrenzen, mit genügend Kontext zum Wiederfinden. Ein Prozentwert im Fehlerzustand ist kein Vergleichsergebnis.
Prüfen Sie beide vollständigen Eingaben, deaktivieren Sie alle Regeln und vergleichen Sie eine kurze Stelle zeichenweise. NFC setzt weder gerade und typografische Anführungszeichen noch normale und geschützte Leerzeichen oder ähnlich aussehende lateinische und kyrillische Buchstaben gleich. Zeichentoken sind Codepunkte, nicht ganze Emoji- oder Graphemgruppen. Für Formatierung, Kommentare, Tabellen und Binärkodierungen brauchen Sie die Originaldatei oder ein dateibewusstes Vergleichswerkzeug.
Der lokale Vergleich begrenzt Eingaben auf 50.000 JavaScript-Zeicheneinheiten pro Feld und beschränkt den Rechenaufwand. Zeilen können Abstände zusammenfassen, Wörter Leerraum normalisieren und Zeichen Leerraum entfernen.
Ignorierte Unterschiede können in der Anzeige fehlen, bleiben aber im exakten Patch enthalten. Zeichen sind Unicode-Codepunkte, nicht immer vollständige sichtbare Zeichen. Große Änderungen können das Arbeitslimit erreichen. Syntax und Sicherheit werden nicht geprüft.
Ignorierregeln ausschalten, Eingaben prüfen und kleinere Abschnitte vergleichen. Für einen Fehlerbericht ein kurzes erfundenes Beispiel mit Einheit und Normalisierungseinstellungen verwenden.
Nein. Er beschreibt die exakten Eingaben einschließlich ausgeblendeter Unterschiede.
Nein. Der Inhalt wird als Text dargestellt und wörtlich verglichen.
Längen- und Arbeitslimits begrenzen den Aufwand. Dokumente in kleinere relevante Abschnitte aufteilen.
NFC behandelt kanonische Unicode-Gleichwertigkeit, nicht jede optische Ähnlichkeit. Verwechselbare Buchstaben, unsichtbare Zeichen, geschützte Leerzeichen und Anführungszeichen können verschieden bleiben. Vergleichen Sie ein kleines Fragment exakt und prüfen Sie bei Bedarf die Codepunkte in einem geeigneten Editor. Entfernen Sie unsichtbare Zeichen nicht blind aus Kennungen oder Code.
Ja. Eine Verneinung, ein Datum, Dezimalpunkt oder Berechtigungswert kann wichtiger sein als Tausende unveränderte Token. Der Wert beschreibt Zuordnung und Regeln, keine semantische Qualität, Plagiatserkennung oder Freigabe. Lesen Sie jede für den Zweck relevante Änderung.
Der Algorithmus beschreibt Ergänzungen und Löschungen, keine inhaltliche Verschiebung. Ein Absatz kann an einer Stelle entfernt und anderswo ergänzt werden. Wiederholungen beeinflussen die Zuordnung. Prüfen Sie in geteilter Ansicht Nachbarabsätze und Endreihenfolge; ein farbiger Block muss kein neu verfasster Text sein.
Eingaben bleiben im Arbeitsspeicher der Seite und werden nach Neuladen nicht als gespeicherter Vergleich wiederhergestellt. Teilen öffnet das Werkzeug ohne die Texte. Bewahren Sie Originale oder Export vor dem Verlassen auf. Ein Patch enthält Änderungen an den Texten und verdient denselben sorgsamen Umgang.
Mit exakten Regeln gilt der nichtleere Text gegenüber einer leeren Eingabe vollständig als ergänzt oder entfernt. Zwei leere Eingaben ergeben vereinbarungsgemäß 100 %, aber keinen geprüften Dokumentvergleich. Ignorierregeln können ausschließlich aus Leerraum bestehenden Inhalt entfernen. Prüfen Sie Eingaben und Berechnungsstatus.