Шаг 1
Вставьте группы
... --- ... / .x-SOS [?]Разделяйте символы пробелами, слова — / или переносом строки. Допускаются типографические варианты.
Расшифруйте разделённые точки и тире, сохраните неизвестные группы и выберите трактовку служебных сигналов.
Расшифруйте разделённые точки и тире, сохраните неизвестные группы и выберите трактовку служебных сигналов.
... --- ... / .x-SOS [?]Разделяйте символы пробелами, слова — / или переносом строки. Допускаются типографические варианты.
Неизвестные символы сохраняются. Сравните каждую отметку [?] с исходной группой.
.x-[?]Включите служебные знаки при необходимости и проверьте текст перед копированием.
Сохраните копию подсказки точно в полученном виде. Вставьте одну короткую строку, проверьте разделители слов и используйте «Нормализовать интервалы», чтобы стандартизировать принятые типографские элементы. Если ... --- ... / .x- дает SOS [?], изолируйте .x- и сравните с источником или таблицей. Не удаляйте x только потому, что .- дало бы правдоподобную A. Когда отправитель подтвердит задуманную группу, исправьте именно эту группу и снова декодируйте всю подсказку. Так остается понятная цепочка между тем, что дала головоломка, что распознал конвертер и что вы изменили.
Скопируйте фактические точки и тире из макета, а не свежую конвертацию предполагаемой фразы. Для имени или даты сравните результат посимвольно с утвержденным источником. Проверьте, не превратил ли перенос строки в макете границу слова и принимается ли декоративное длинное тире как тире. Если все группы допустимы, но слова неверны, ищите потерянные пробелы: допустимость не обнаруживает переставленное сообщение. Исправьте макет и повторите проверку на финальной версии до заказа печати.
Для короткой сгенерированной учебной фразы один раз послушайте с фиксированными настройками, запишите символы, которые, как вам кажется, вы услышали, и при необходимости отдельно транскрибируйте группы элементов. Используйте декодер для проверки спорной группы, затем сравните свой текст с исходной фразой. Для второго прохода оставьте скорость символов 18 WPM и снизьте скорость Фарнсворта до 10 WPM, если проблема в том, чтобы успевать между буквами. Эта страница помогает проверять транскрипцию; она не оценивает ваш слух, не захватывает микрофонный ввод и не распознает загруженную запись.
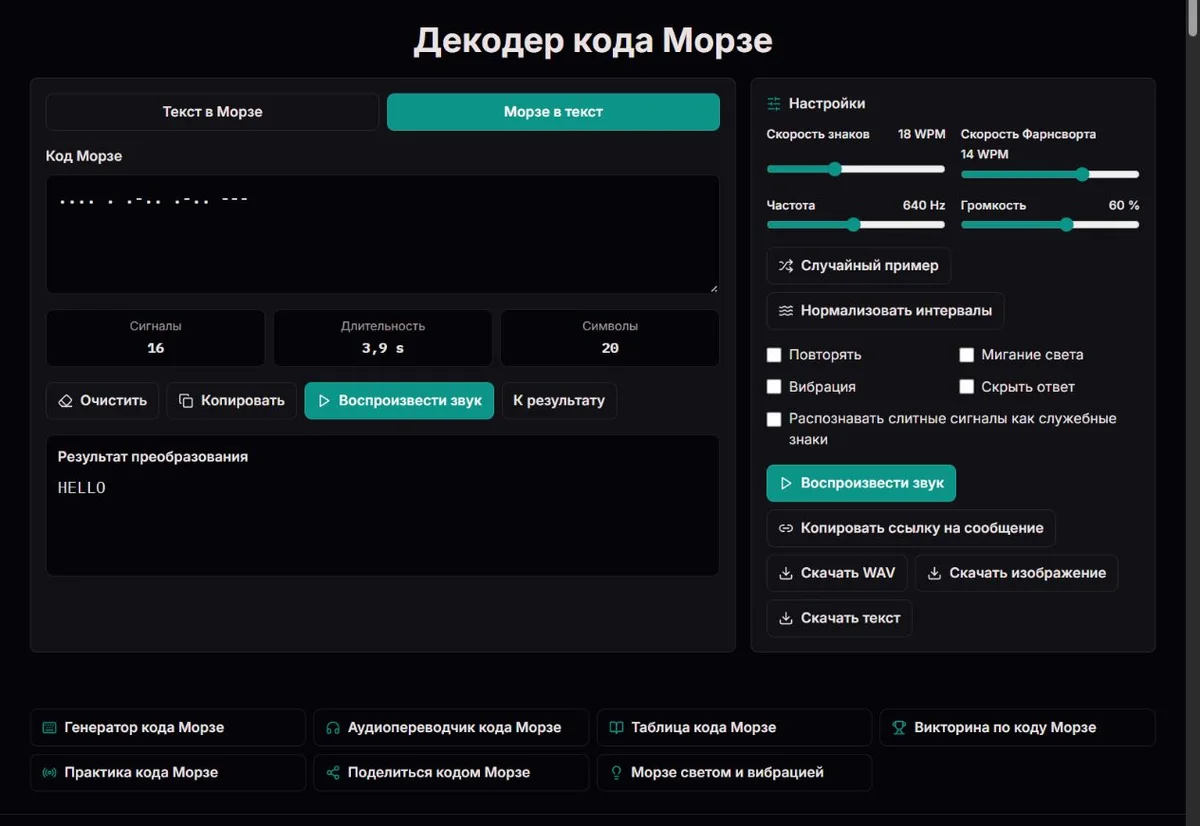
Вводите точки и тире с пробелами между группами символов. Косая черта делит слова, а перенос строки трактуется как еще один разделитель слов. Начальные или повторяющиеся разделители слов очищаются, а не создают пустые слова. Преобразованный текст обновляется из нормализованных групп, но все еще зависит от границ, которые вы указали. Обычные пробелы в этой записи не являются сигналом границы слова.
Сравните ..., . . . и . / . / .. Первое это S, второе EEE, третье E E E. Непрерывный поток нельзя однозначно декодировать, потому что шаблоны символов азбуки Морзе имеют разную длину. Даже .- может быть A или E, за которой следует T, если допустить отсутствующую паузу. Декодер, который выбирает правдоподобное слово, угадывал бы, а не восстанавливал информацию, сохраненную во вводе.
Когда отправитель передал раздельные буквы, но без разделителей слов, буквы все еще могут декодироваться, хотя деление на слова потеряно. Попросите исходную группировку до добавления разделителей. Если длинная подсказка только визуально перенесена, намеренно удалите редакционные переносы строк, сохраняя настоящие разделители слов. Не сливайте все в один поток; границы букв важнее компактности ввода.
| Ввод азбукой Морзе | Результат | Интерпретация |
|---|---|---|
... | S | Один символ |
. . . | EEE | Три символа в одном слове |
. / . / . | E E E | Три односимвольных слова |
..--.. | ? | Распознанный вопросительный знак |
| .x- | [?] | Нераспознанная группа, требующая проверки |
Декодер принимает обычные точки как точки азбуки Морзе, а дефисы как тире. Средние точки и маркеры становятся точками; типографские тире разной длины и математические минусы становятся дефисами. Вертикальная черта или обратная косая черта нормализуется в разделитель слов. Повторяющиеся пробелы и разделители приводятся к единому виду. Эти изменения полезны при копировании кода из документа с типографскими заменами.
Нормализация интервалов сохраняет незнакомые символы внутри группы. Поэтому .x- остаётся недопустимым, а не превращается незаметно в .-. Удаление x создало бы A и скрыло исходную проблему. То же относится к запятым вместо точек, декоративным знакам или ошибке оптического распознавания. Нормализация упорядочивает допустимую запись, но не распознаёт изображение и не заменяет любой похожий знак точкой или тире.
Сохраните оригинал перед нормализацией транскрипции архивного материала. Нормализованная рабочая копия может легче декодироваться, но она больше не сохраняет точную типографику, разметку строк или разделители источника. Если контекст важен, отметьте, какие изменения были механическими, а какие потребовали редакционного решения. Для учебной подсказки это возможность различить изменение представления и изменение информации.
... --- ... / .x- дает SOS [?]. Распознанные группы сохраняются, а недопустимая группа видна в результате и предупреждении. [?] это заполнитель, а не результат для закодированного вопросительного знака. Настоящий вопросительный знак это ..--.., и он декодируется как ?. Сохраняйте это различие при проверке подсказки, где есть и неопределенность, и пунктуация.
Неизвестные группы перечисляются в предупреждении отдельно, поэтому список не обязательно является счетом каждого появления. Используйте вывод, чтобы найти повторяющиеся заполнители и проверить соответствующие входные группы. Одна недопустимая группа мешает создать допустимую временную шкалу для всего ввода азбуки Морзе. Удаление группы сделало бы оставшуюся последовательность воспроизводимой, но также удалило бы информацию; делайте это только если явно нужен неполный фрагмент.
Допустимый результат все равно может быть неправильным. Если ... должно было быть ...., конвертер вернет S, а не обнаружит потерянную точку H. Если пробел символа поставлен неправильно, две допустимые более короткие группы могут заменить одну задуманную букву. Поэтому смысл и сравнение с источником остаются необходимыми даже без предупреждения. Считайте допустимость как «распознано картой», а не «подтверждено отправителем».
Несколько соединенных сигналов пересекаются с показанной пунктуацией. .-.-. обычно декодируется как +, но предпочтение prosign делает его <AR>. .-... обычно декодируется как дополнительный шаблон & и становится <AS> с этим предпочтением. Настройка не изменяет входные элементы или их звук; она выбирает текстовое представление для пересекающейся группы.
Соединенные ...-.- и ...---... не имеют обычной пунктуационной записи в этой карте, поэтому они декодируются как <SK> и <SOS> даже с выключенным предпочтением. Раздельное ... --- ... остается тремя буквами SOS. Так же .- .-. остается AR, а не становится соединенным prosign. Пробелы сообщают декодеру, что буквы были отдельными.
МСЭ-R M.1677-1 дает процедурные значения и правила передачи, а не просто список взаимозаменяемых подписей. Его сигналы ожидания (wait) и окончания работы (end-of-work) помогают объяснить соглашения AS и SK, использованные здесь. Он также включает восьмиточечный сигнал ошибки, сигнал «понято» (understood) и начальный сигнал (starting signal), которые не поддерживаются как токены в этом инструменте. Поэтому восьмиточечная группа здесь будет неизвестной, хотя в документе она имеет определенную роль. Не называйте каждую неизвестную группу бессмысленной или каждую принятую подпись полным рабочим протоколом.
| Соединенный ввод | Предпочтение выключено | Предпочтение включено |
|---|---|---|
.-.-. | + | <AR> |
.-... | & | <AS> |
...-.- | <SK> | <SK> |
...---... | <SOS> | <SOS> |
Декодер возвращает заглавные буквы, цифры, É и сопоставленную пунктуацию. Он не сохраняет регистр источника и не переводит сообщение на язык страницы. Русскоязычное объяснение не превращает латинскую группу азбуки Морзе в кириллический символ. Разные алфавиты или национальные адаптации могут использовать некоторые одинаковые шаблоны; этот инструмент применяет соответствие, показанное в его таблице.
Письменный разделитель слов / отличается от группы символа -..-., которая декодируется как буквальная косая черта. Для дроби или даты, скопированной в записи азбукой Морзе, сохраняйте эту группу, а не заменяйте ее разделителем. Умножение имеет общий -..- с X и декодируется как X. Контекст сообщения может подсказать предполагаемый знак умножения, но конвертер не восстанавливает исходную типографику из идентичного сигнала.
Вид пунктуации помечает !, &, ;, _ и $ как дополнительные шаблоны, а не пунктуационные записи в цитируемой таблице ITU. Головоломка может намеренно использовать их, но другой инструмент или рабочее соглашение может отличаться. Если принятая группа дает неожиданную пунктуацию, сравните таблицу и источник до переписывания. Проценты и рабочее форматирование чисел не интерпретируются автоматически; читаемая транскрипция не является вычисленным выражением или проверенной координатой.
Начните с самого маленького спорного фрагмента и его источника. Сначала проверьте, правильно ли скопированы элементы. Затем изучите пробелы между буквами и настоящие разделители слов. После этого нормализуйте принятую типографику. В конце проверьте процедурный контекст и опцию prosign. Такой порядок отделяет проблему ввода от выбора представления. Повторный запуск той же поврежденной строки с другими настройками скорости не исправит текст, потому что WPM влияет только на воспроизведение.
После согласованного исправления снова декодируйте полное сообщение и сравните как новый исправленный участок, так и его соседей. Изменение разделителя может затронуть больше одной буквы. Если результат предназначен для печати, повторите проверку на финальном макете, а не только на промежуточном текстовом файле. Если сообщение получено от другого человека, сохраняйте указание на неопределенный материал, а не молча представляйте угаданное слово как подтвержденное.
Аудиовоспроизведение является необязательным сравнением после того, как все группы стали допустимыми. Для визуальной проверки S против H таблица обычно быстрее. Чтобы различить A и N по ритму, попробуйте одну и ту же скорость символов и высоту тона для обеих. Воспроизведение доказывает, что распознанную письменную последовательность можно сгенерировать как тоны; оно не доказывает, что ваша транскрипция совпадает с записью, и автоматического декодера аудиоввода для такого сравнения здесь нет.
Для самопроверки в режиме Морзе в текст можно скрыть ответ: сначала попробуйте прочитать код, затем откройте расшифровку. Случайное слово заменяет текущий ввод учебным словом в выбранной записи, поэтому заранее сохраните оригинал. Копирование и скачивание текста сохраняют расшифровку вместе с обозначениями [?]. PNG и WAV, напротив, представляют введённый код Морзе; для WAV все группы должны быть распознаваемыми. Храните оригинал как запись исходного материала рядом с исправленной расшифровкой, если изменения должны оставаться проверяемыми.
Лента Библиотеки Конгресса с сообщением 1844 года показывает записанное сообщение, отправленное Сэмюэлом Морзе Альфреду Вейлу в 1844 году. Операторы могли работать с физической записью, а саундер, такой как телеграфный саундер из коллекции Смитсоновского института, позволял интерпретировать электрические импульсы через слышимые щелчки. В обоих случаях человек должен был определить шаблоны и границы. Современный текстовый декодер начинает после этого определения: он получает явные группы, а не неоднозначный реальный сигнал.
Это различие также объясняет ценность ранних морских примеров. Congressional Record 1909 года о Джеке Биннсе фиксирует вызовы бедствия CQD от Джека Биннса в 1909 году; рассказ Музея науки о радиосвязи на «Титанике» описывает, как вызовы и сообщения «Титаника» принимались другими судами в 1912 году. Распознанный сигнал бедствия был только частью обмена, которому также требовались идентификационные сведения и внимательные операторы. Эти истории не показывают, что изолированный перевод SOS содержит все необходимое для полезной связи.
Для визуального примера архивная запись National Archives об интервью Джеремайи Дентона документирует слово TORTURE, переданное миганием во время интервью в 1966 году. Человеческая интерпретация записи во времени отличается от ввода разделенных групп здесь. Обучая на этом эпизоде, различайте историческое свидетельство, вашу транскрипцию и вывод конвертера. Придуманную расшифровку или сгенерированный аудиообразец нельзя представлять как исходную запись.
... --- ... / .x-SOS [?]Буквы A–Z, цифры и стандартная пунктуация соответствуют МСЭ-R M.1677-1. Пять дополнительных знаков отмечены в таблице. <AR>, <AS>, <SK> и <SOS> передаются слитно; декодер может предпочесть служебное значение при совпадении с пунктуацией. Используются единицы 1/3/7. Метод Фарнсворта удлиняет только межбуквенные и межсловные паузы по условному слову PARIS из 50 единиц. Звук, длительность и WAV используют одну временную последовательность.
Микрофон, радиоприёмник, камера и фонарик не используются. Неподдерживаемые символы отмечаются и пропускаются при кодировании; неизвестные группы Морзе остаются как [?] и блокируют воспроизведение. Для звука нужен работающий аудиоинтерфейс браузера. Экран и вибрация могут запаздывать; спящее устройство или фоновая вкладка не обеспечивают надёжную передачу. Скрытие вкладки останавливает звук. Занятия не сохраняются. Ссылка содержит полное сообщение без шифрования. Буква É с акцентом поддерживается и в разложенной записи Unicode. Знак умножения × использует сигнал буквы X и поэтому декодируется как X: по одному сигналу их нельзя различить. Проценты и другие специальные форматы чисел автоматически не разворачиваются.
При сообщении об ошибке укажите страницу, точный ввод, ожидаемый результат и настройки. Для проблем с ритмом нужны обе скорости. Сверьтесь с официальной таблицей до изменения идентификатора и удалите личные данные из обращения.
Проверьте, что вы вставили точки и тире, а не обычные слова, и что у каждого символа есть пробельная граница. Осмотрите незнакомые знаки перед нормализацией. Если группы нет в поддерживаемой карте, [?] сохраняет эту неопределенность; изменение высоты или скорости не изменит декодированный текст.
В общем случае не однозначно. Группы азбуки Морзе имеют переменную длину, поэтому непрерывный поток допускает разные деления. Восстановите границы из оригинала или попросите отправителя дать разделенную версию. Правдоподобное предложение, полученное угадыванием, не является проверенным декодированием, даже если каждая угаданная группа допустима.
Новая строка нормализуется как граница слова. Это полезно для кода, написанного по одному слову на строку, но не для строки, перенесенной только по ширине страницы. Удалите редакционный перенос, сохранив настоящие пробелы символов и разделители слов. Сохраните исходную версию, если транскрибируете исторический материал.
Нет. Она стандартизирует принятые символы и разделители, но оставляет незнакомый символ, например x в .x-. Удаление x молча создало бы A. Сравните с оригиналом и исправьте конкретную опечатку намеренно; нормализация не является общим алгоритмом исправления ошибок.
..--.. это сопоставленный вопросительный знак, который возвращает ?. [?] это заполнитель инструмента для нераспознанной группы. Различие позволяет транскрипции содержать намеренный вопрос, не делая его похожим на сбой. Сохраняйте заполнители, пока соответствующий ввод не проверен.
Соединенный шаблон .-.-. пересекается со знаком сложения/крестом и соглашением AR. Включите предпочтение prosign, когда источник использует его процедурно. Опция меняет отображаемую интерпретацию, а не звук, и не может определить, имел ли отправитель в виду арифметику или сигнал конца сообщения.
Документ ITU его определяет, но этот инструмент реализует только показанную карту и четыре явных токена AR, AS, SK и SOS. Это не полный парсер всех рабочих процедур. Сохраните оригинал и отдельно аннотируйте этот процедурный сигнал, а не считайте его поврежденной буквой.
Да. Пропущенная точка может превратить H в допустимую S, а ошибочный разделитель может создать допустимые, но не задуманные буквы. Предупреждение обнаруживает неизвестные группы, а не отклонения от смысла отправителя. Сравните результат с источником или запросите повтор, если сообщение важно.
Расшифровка сохраняет распознанные группы и заполнители, поэтому полезна для расследования. Воспроизведению нужна допустимая временная шкала для каждой группы, и оно отклоняет недопустимую запись азбукой Морзе. Копирование SOS [?] не подтверждает отсутствующую группу; исправьте оригинал перед экспортом полного аудиосигнала.
Нет. В нем нет анализа записи или приема с микрофона. Вы можете ввести вручную разделенную транскрипцию и использовать таблицу или сгенерированное воспроизведение для сравнения. Документируйте неуверенные элементы или паузы, а не предполагайте, что инструмент восстановил детали, которых вы не предоставили.